AI 工具
不动模型,只改 8 个文件,agent 涨 11.5 分
GLM-5 跑在 OpenCode 里做 WorkBuddy-Bench,原来 64.2 分。模型一个参数没动,只改了模型外面那圈文件,一轮之后到了 75.7,比没优化过的 Gemini 3.5 Flash(72.4)还高。
 Stometa
GLM-5 跑在 OpenCode 里做 WorkBuddy-Bench,原来 64.2 分。模型一个参数没动,只改了模型外面那圈文件,一轮之后到了 75.7,比没优化过的 Gemini 3.5 Flash(72.4)还高。
这是 Google Cloud AI Research 和 Northwestern 一起做的 Harness²,论文 10 月 9 日挂上 arXiv(2610.14224),代码在 GitHub 开源,Apache 2.0。它干的事说起来很简单,用一个 agent 去改另一个 agent 的 harness。
harness 到底是哪一圈?
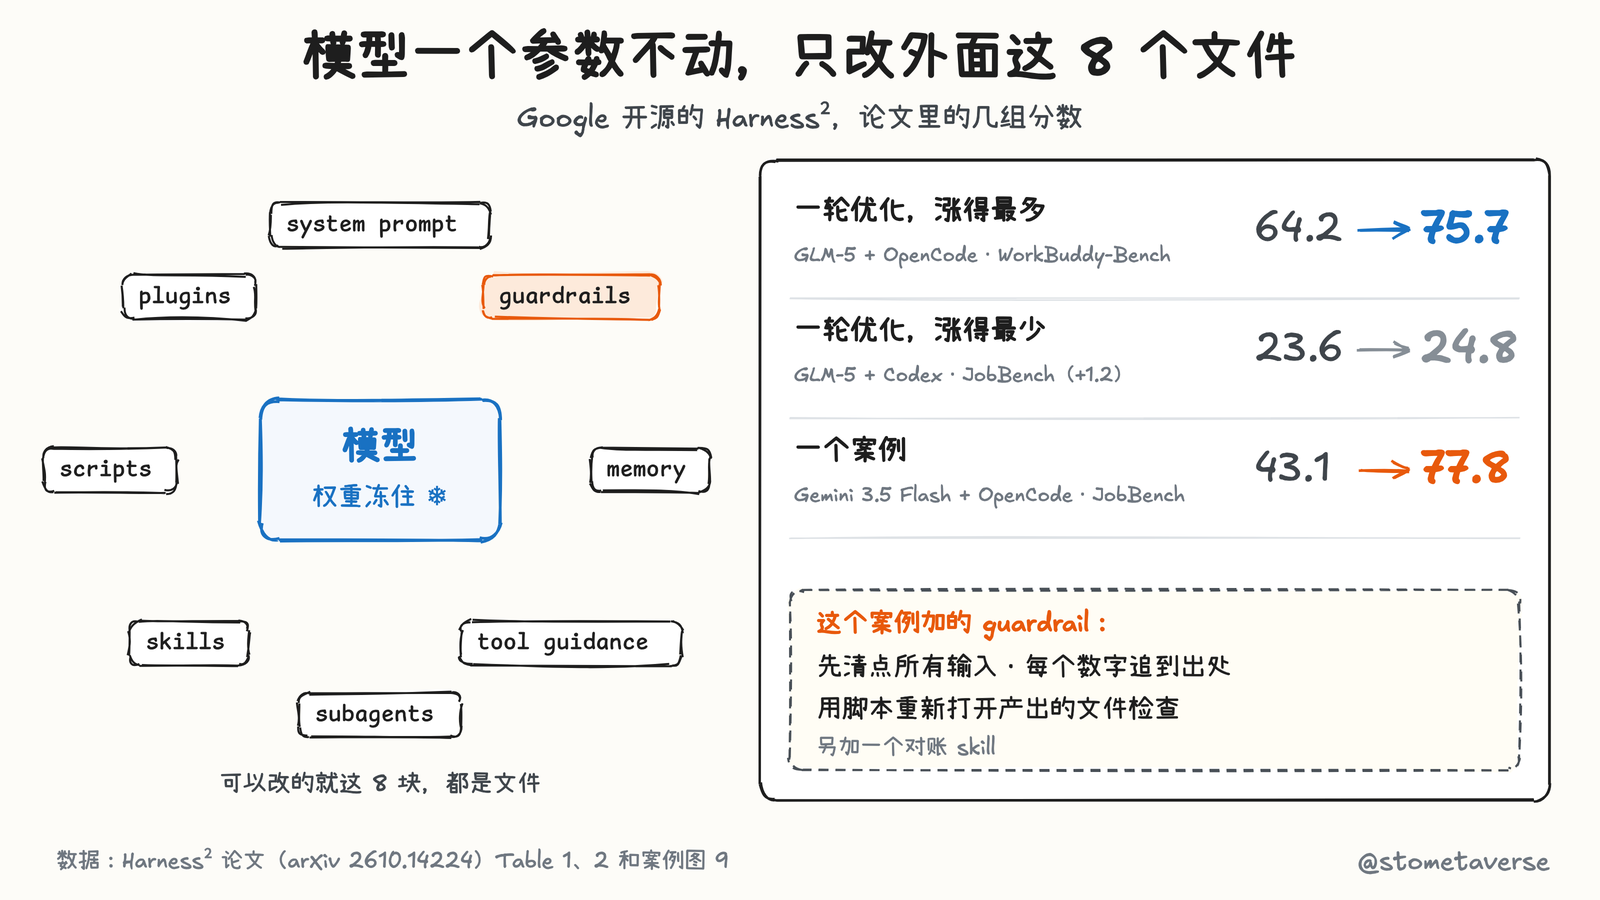
README 的定义是,harness 是模型外面那套让它能当 agent 干活的系统,prompt、工具、memory、skills、编排都算。harnessing 就是去优化这套系统。
Harness² 把能改的东西收成 8 个组件:system prompt、guardrails、memory、tool guidance、subagents、skills、scripts、plugins。它们管的是上下文怎么拼、工具接口长什么样、活怎么分给 subagent,还有工具循环里 agent 的行为。全是文件,模型权重一直冻着。
没有标准答案,它怎么知道改对了?
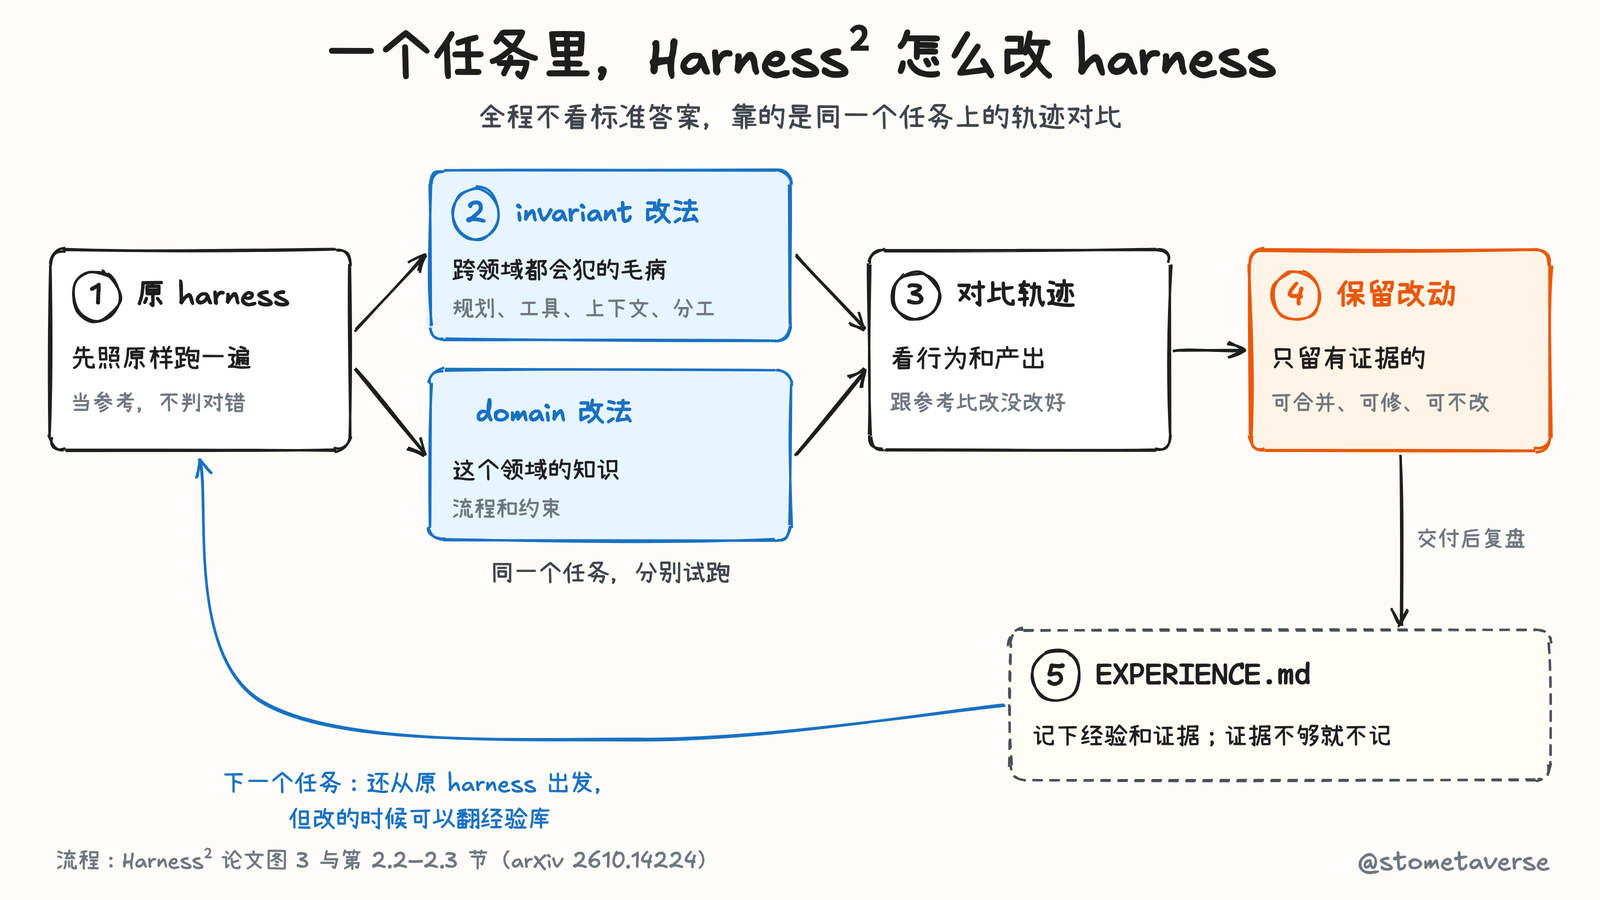
论文盯的是 open world 的场景,任务在设计 harness 的时候没见过,也没有 ground-truth verifier(能直接判对错的标准答案)。所以它换了个判断依据,在同一个任务上对比轨迹。论文管这一步叫 Propose–Probe–Compose,对着上图一步步说:
① 先照原样跑一遍
先用原来的 harness 把任务跑一遍,当参考。这一遍只用来看 harness 怎么表现,不判断交付物对不对。
② 提两个改法(Propose)
然后 editor 提两个改法。一个叫 invariant,针对跨领域都容易犯的毛病,比如规划、工具使用、上下文管理、分工;另一个叫 domain,针对当前领域的知识、流程和约束。两个改法都是直接改那几个组件文件得到的、能跑的 harness。
③ 同条件试跑、对比轨迹(Probe)
两个改法在同一个任务、同样的模型和环境下分别试跑。
④ 只留有证据的改动(Compose)
composer 拿它们的轨迹、产出和 diff 跟参考那一遍对比,决定怎么合:可以合并有证据的改动,可以修掉互相冲突的,也可以只采用一个,或者干脆保持原样。每个决定都要对得上一条具体的观察。 合完的 harness 再跑一遍,产出交付物。
⑤ 写进 EXPERIENCE.md
任务做完还有一层。reflector 回看整个改进过程,哪些改动解决了哪个毛病、在什么条件下、带来什么后果,写进一个 EXPERIENCE.md,连同采纳的 harness 一起放进经验库。证据不够的时候,它就不新增经验。下一个任务还是从同一个初始 harness 出发,但 editor 改的时候可以翻这个库。
论文自己也说得挺克制,这种对比只是给 composer 参考,不能拿来验证任务做对没有,因为执行本身有随机性,模型之间也有共同的偏差。
上面说的是单步(k=1)。k 可以调大,parallel 是一次多探几个改法再合,sequential 是一步接一步往深里改。GLM-5 + OpenCode 那组在 WorkBuddy-Bench 上,k=5 的 parallel 又多涨了 3.9 分。
四组配置各涨了多少
论文测了三个 benchmark:WorkBuddy-Bench(办公类交付,分 Code、Web、Office 三块),JobBench(端到端的职业任务,执行很长),LAB(Harvey 的法律工作 benchmark)。执行的模型(executor,真正跑任务的那个)是 GLM-5 和 Gemini 3.5 Flash,外面套的是现成的 OpenCode 和 Codex,一共四种组合。
单步下来,GLM-5 在 WorkBuddy-Bench 用 OpenCode 涨了 11.5 分,是这个 benchmark 上最大的一步;换成 Codex 也到了 75.3,超过没优化的 Gemini(74.5)。LAB 上最多涨 11.8 个百分点(按单条评分标准的通过率算)。
涨得最少的是 GLM-5 + Codex 跑 JobBench,23.6 到 24.8,只多了 1.2 分,和最大那组差了将近 10 倍。JobBench 上四组的单步涨幅是这样:
JobBench 单步涨幅
OpenCode:Gemini 3.5 Flash +4.5,GLM-5 +3.6
Codex:Gemini 3.5 Flash +1.4,GLM-5 +1.2
论文里有个规律,在 WorkBuddy-Bench 和 LAB 上,弱一点的 GLM-5 拿到的绝对涨幅都比 Gemini 大。
两个对照方法反而有掉分的。ReasoningBank(固定 harness,只往上下文里塞从过去轨迹里提炼的策略)在 coding 任务上最多比原始 harness 低了 6.6 分;Harness Scaling(每个任务多花推理预算改 harness,但不跨任务记东西)在 12 组 benchmark 和配置里有 7 组不如原始 harness。
一个从 43.1 分改到 77.8 分的任务
论文图 9 讲了一个 JobBench 任务,Gemini 3.5 Flash + OpenCode,原来 43.1 分。
看轨迹,毛病出在流程上。几份源文件的数据从来没对过账,产出的文件写完就没再打开检查。
这个例子我挺有共鸣。两个改法都很朴素。invariant 那边加了一条流程层面的 guardrail:
先清点所有输入,每个数字追到它的出处,用一个验证脚本把产出的文件重新打开检查。
domain 那边加了一个对账的 skill,专门处理排期、场地、人工和预算几类文件,再配上处理特定数字格式的 tool guidance。
composer 对比之后,两个改法带来的 4 处改动全留下了。重跑的时候,数字能互相对上了,memo 里缺的几节也补回来了,分数到 77.8,差不多是原来的 1.8 倍。
这些分数该信几成?
有一点要留个心眼。默认负责改 harness 的 editor 是 Claude Opus 4.8,JobBench 的打分也是 Claude Opus 4.8,按加权 rubric(评分细则)打,rubric 不给 executor、editor 和 selector(k>1 时从几份交付物里挑最终版的 agent)看。改的和判的是同一个模型。
WorkBuddy-Bench 的打分是另一套,确定性的检查(隐藏测试、文件和结构检查)加上 LLM 和 VLM judge(用语言模型、视觉语言模型当裁判),需要 judge 的地方用的是 Gemini 3.5 Flash,期望值也不暴露给流程里的任何模型。所以我会更看 WorkBuddy 那组。
论文也做了一组实验回应「是不是靠更强的 editor」。在 OpenCode、k=2 的设置下,让同一个模型既当 executor 又当 editor,从 GLM-5 到 Claude Opus 5 一共五个模型,每个 benchmark 上都涨了,GLM-5 在 LAB 上涨了 13.7 分。
还有一条是 README 自己写的提醒。executor 的网络访问不受限,Codex 跑的时候 sandbox 是关的,公开 benchmark 的 rubric 网上可能搜得到。正式评测之前要先配网络限制,不然 agent 有可能直接搜到答案和评分标准。
想自己试的话
先跑本地 demo(不花钱)
README 给了一个本地 demo,不需要任何模型 key,用 deterministic editor(规则写死、不调模型的 editor)加真实的 Python 执行,把 parallel 和 sequential 两种模式都跑一遍。环境要 Linux、Python 3.12 和 uv,在 repo 根目录下:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
再跑真实 benchmark(要花 API 钱)
跑真实 benchmark 要多装 Node.js 20+ 和 Google Cloud CLI,模型走 Vertex AI,LAB 还要 Pandoc 和 Poppler,WorkBuddy-Bench 要 Docker。配置是这两步:
cp .env.example .env
gcloud auth application-default login
.env 里填自己的 Vertex AI project 和模型 ID。README 的例子是装 LAB、只跑 1 个任务,再打分、出报告:
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 \
  --mode parallel \
  --only-domains antitrust-competition \
  --max-tasks 1
harness2-judge --bench lab --k 1 \
  --mode parallel
harness2-report --bench lab --k 1 \
  --mode parallel
这一步会花 API 钱,README 建议先挑一个小任务。harness2 后面加 --dry-run 可以先看会选中哪些任务,不调模型。judge 和 report 要跟改 harness 那一轮用同样的 benchmark、executor、subset(比如 WorkBuddy 的 office、web、code)、--k、--mode 和 seed(随机种子)。想换成 Codex 当 executor,加 --substrate cx。
今天就能做的 3 件事
-
有 Linux 和 uv 的,照上面四条命令把本地 demo 跑起来,不花钱,也不用 key。README 说结果存在
runs/下面,有任务总结、交付物、采纳的 harness 和反思记录,可以翻开看看它到底改了哪些文件。 -
把图 9 那条 guardrail 抄进自己 agent 的 system prompt 或 guardrails:先清点所有输入,每个数字追到出处,产出写完用脚本重新打开检查。
-
要跑真实 benchmark,先加
--dry-run看任务选得对不对,再把网络限制配好。
你给 agent 调 harness,改得最多的是哪一块:system prompt、skills,还是 tool guidance?
🔗 链接
-
Harness² GitHub:https://github.com/google-research/harness2
-
论文 Harness²: Recursive Agent Harnessing for an Open World(arXiv 2610.14224):https://arxiv.org/abs/2610.14224
本文为对 Harness² 论文和 GitHub README 的阅读与解读,事实与数字以原文为准,观点部分为个人判断;配图为作者手绘重绘。
首发于 微信公众号(2026-10-19):原文