工程实践
一次设计请求从约 8 美元到约 50 美分,LangChain 删了什么
LangChain 公开 Content Studio:Slack 设计 agent。公司自报中位模型花费约 8 美元→约 50 美分。品味进上下文、删硬规则、审批进代码。
 Stometa
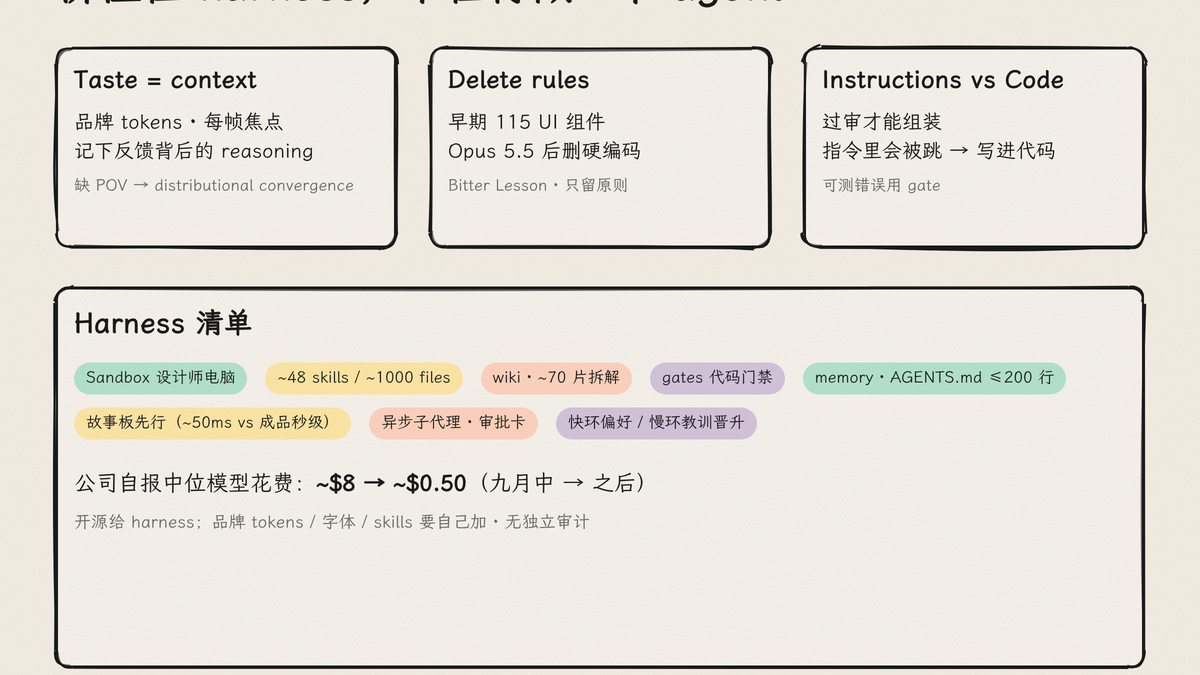
一次设计请求,模型花费的中位数从约 8 美元掉到约 50 美分。
这是 LangChain 2026 年 10 月 27 日博客《How We Built Our Design Agent》里的公司自报数字,对比窗口写的是「九月中」到「现在」。同一篇文章还写了:Content Studio 已交付超过 3,000 件资产、超过 80 套幻灯片;带它视觉的帖在 LangChain 账号上大约 2 倍 likes、3.7 倍 bookmarks;四分之三请求来自营销部门之外,75% 用户每周回流。数字全部来自原文,没有第三方审计。
Content Studio 住在 Slack 里。一句话加附件,吐出视频、社媒图、复刻 UI、幻灯片;资产用代码生成,不是黑盒图文件。GTM Eng 和设计一起做了大约四个月,方法主要是当众看坏输出,再把判断写回 guidance。Harness 已开源,可用 Managed Deep Agents 部署到团队 Slack。
我读这篇,不太想再复述「又一个设计 agent」。更想抄的是:品味怎么进上下文、规则何时该删、哪些事必须写进代码门禁。
模型会画,缺的是你们的上下文
原文第一句关键 takeaway 写得很直:Taste comes from context。模型已经会写 HTML、CSS、图表 spec、动画时间线;缺品牌 POV 时,它会伸手去拿最常见的样子。文中借用 Anthropic 的说法叫 distributional convergence——可以很精致,也仍然像一百个别人。
Stripe 设计负责人 Katie Dill 有个类比:战后急着盖楼时,现代主义的干净外形被一遍遍复制,外形留下了,念头和性格丢了。她管 AI 可能对软件做的同类事叫 zombie UI,并说如果你不给观点,AI 会替你给一个。
LangChain 的对策不是「换更会画的模型」这一句就停。他们从基础 tokens(颜色、字重、间距、对齐、logo)往上加:每帧一个焦点、防常见 AI 设计套路、把反馈背后的 reasoning 记下来。例:「no sharp edges」若只记成圆角,鸟身后的光带还是硬;设计师要的是 soften / taper / fade opposite movement,后来 agent 自己做了帧检,保证丝带根部贴在鸟尾上。
可测的问题迁进确定性检查,比如反复出现的大小写;主观判断(想法够不够强、信息清不清)留在 skills。设计师的角色往 creative director 挪:定方向、审结果,而不是每张图自己画。
115 个组件之后,他们删了大半规则
第一版 harness 试图替模型做设计决定。设计系统塞了 115 个可复用 UI 组件,外加何时用的说明。品牌更稳了,布局和动画也开始重复。
Opus 5.5 上来后质量跳了一截。他们回头删掉大部分硬编码规则,只留设计原则和高层 guidance,结果更多样、更少重复。原文把这标成自己的 Bitter Lesson,并写成一句可执行的话:Delete rules when the model improves.
补偿模型短板的规则会过期。耐久投资,原文列的是 tools、context、files、memory、human feedback、flexible orchestration。硬把创意决定预制成组件,模型变强之后会变成枷锁。
创意判断放指令,必须成立的顺序放代码
片库流水线有个例子:每个 act 过审之后才能组装。这条先写在 skill 指令里,agent 有时为了省时间跳过审查。后来迁进代码,组装会等审查通过;指令继续管创意判断。
Instructions vs Code 这条和企业里「审批能不能被 prompt 绕开」是同构的。会过期的 workaround 写进 prompt;永远要成立的不变量写进 gate。
Harness 长什么样(只记能带走的层)
每个 Slack 线程一台独立 Linux sandbox:文件系统、shell、设计与媒体工具,项目活在线程生命周期里。改时间线再渲,不必整片重生。
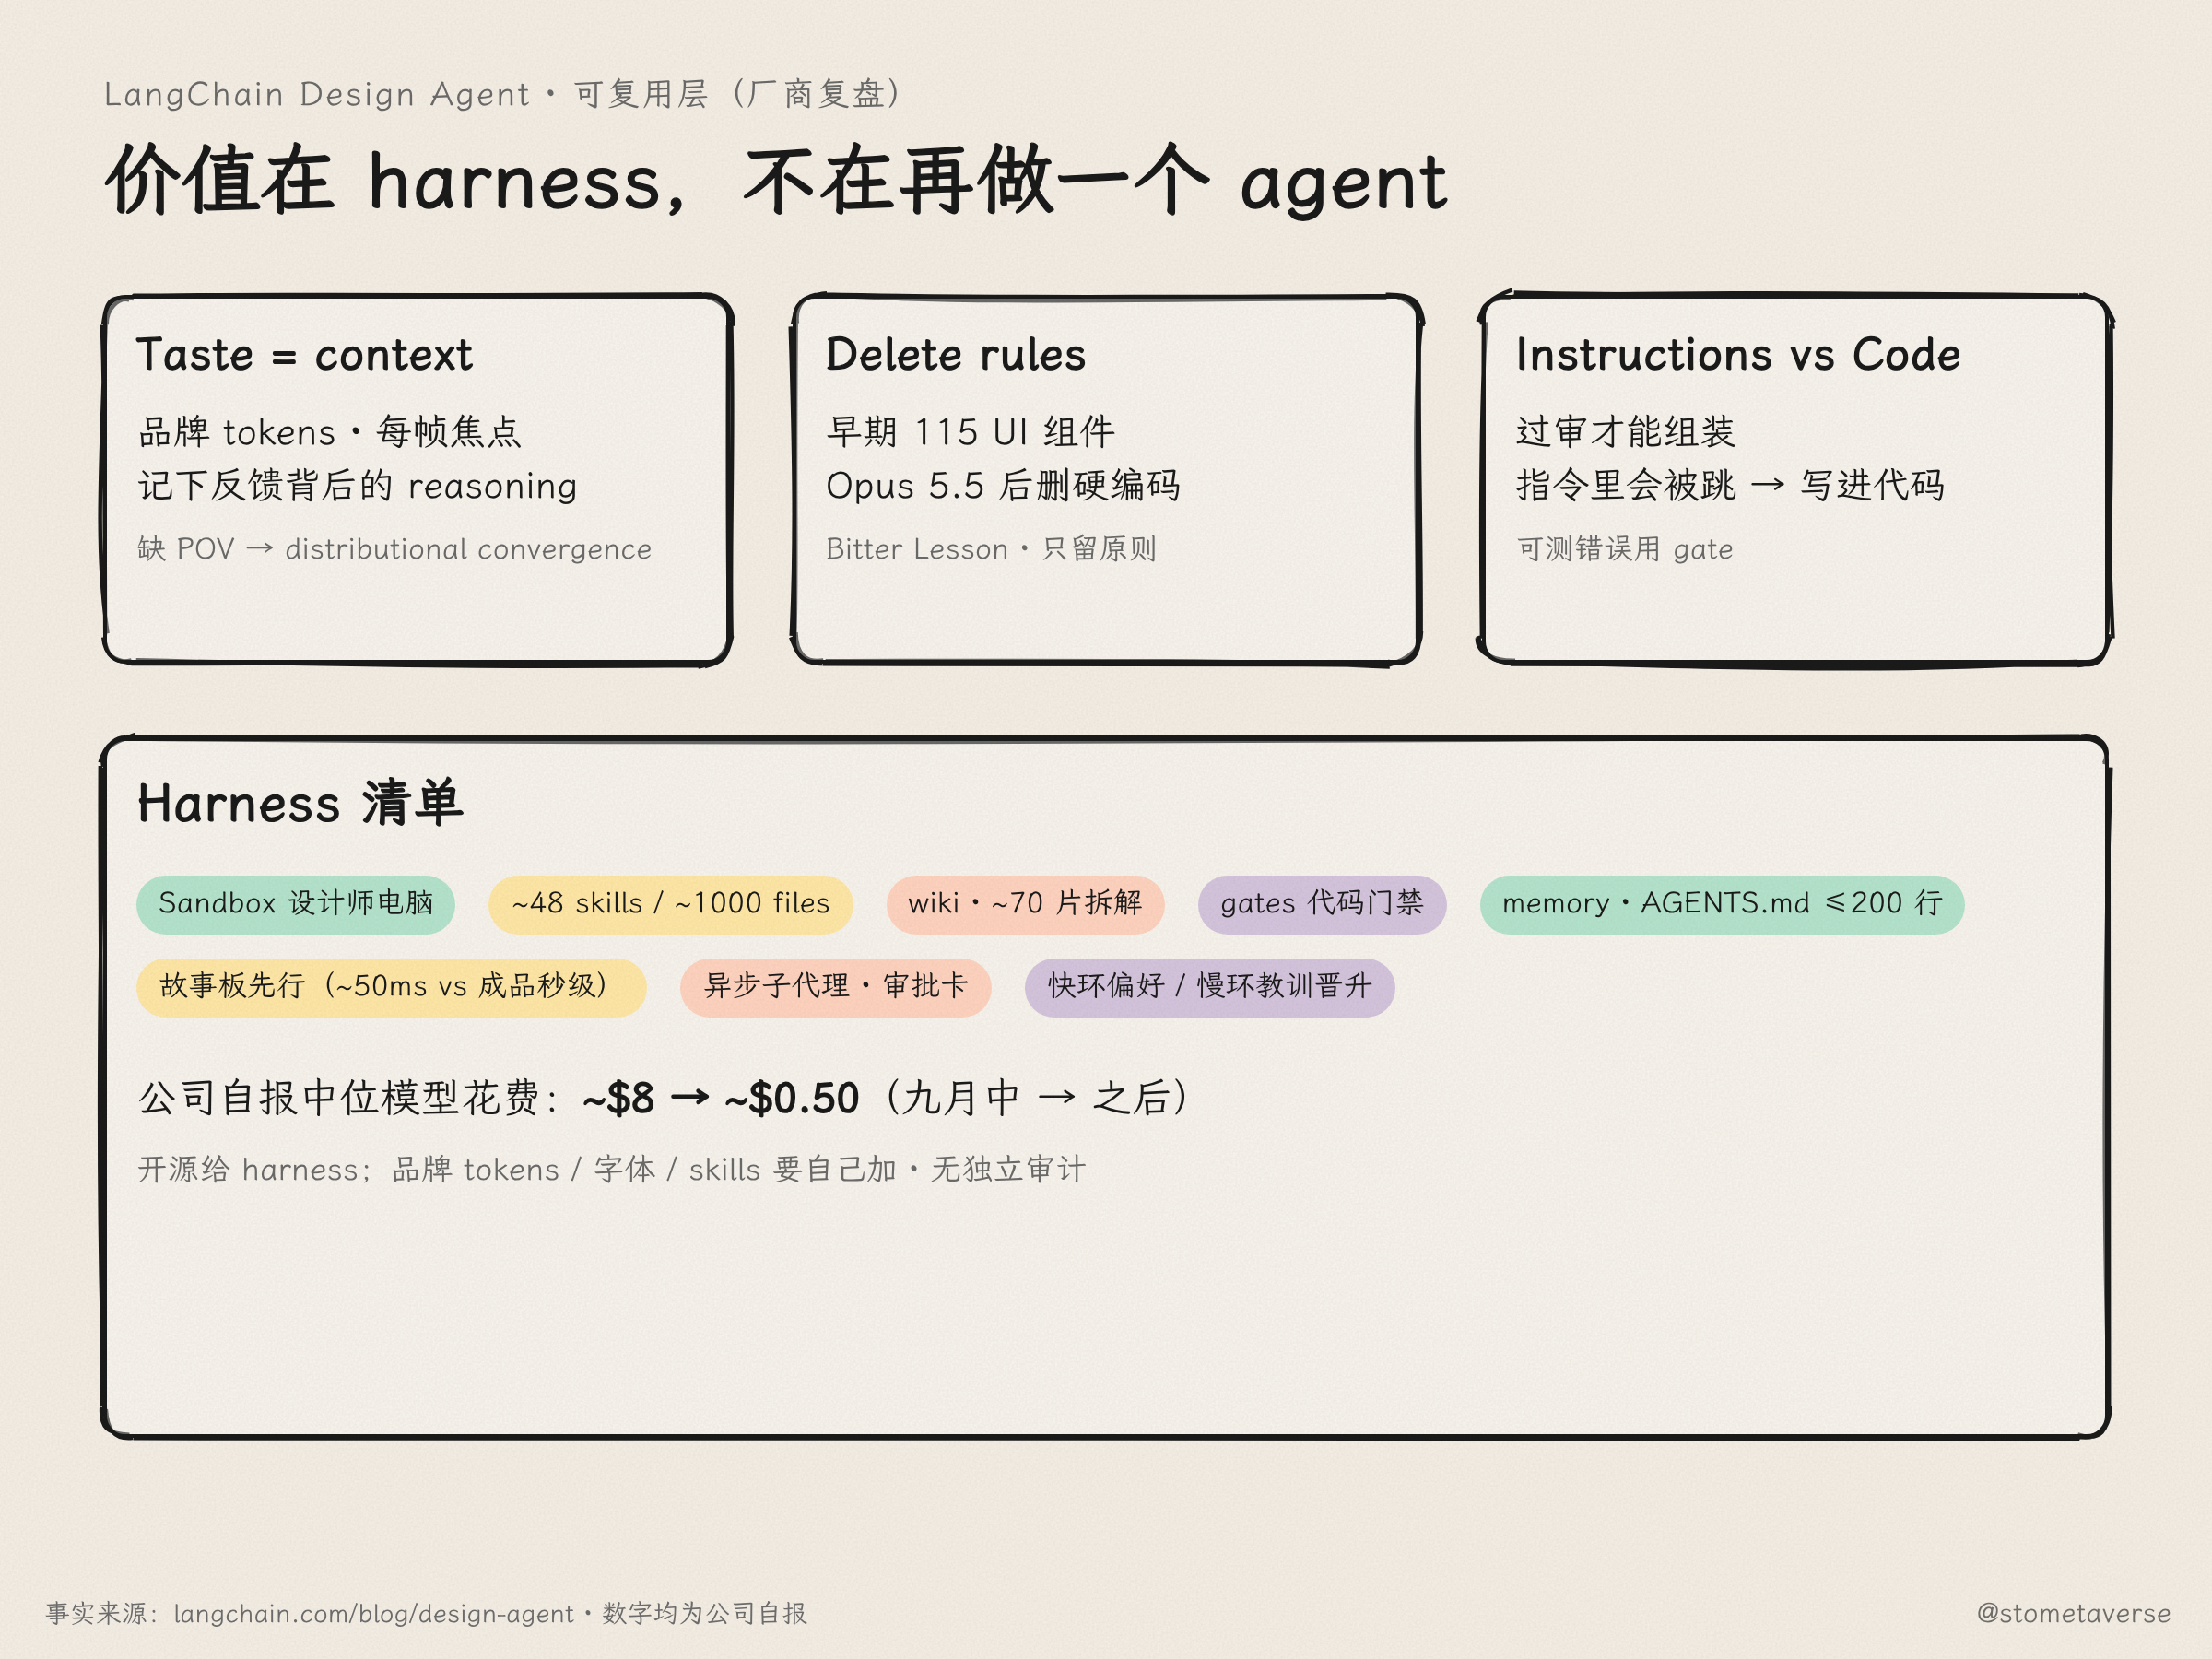
脑子拆成四块:skills(约 48 个、近 1,000 个文件,按岗位路由,描述里写 when not to use)、wiki(品牌、战役、产品、motion;70 部参考片拆解)、确定性 gates、memory(团队共享优先于个人;AGENTS.md 限约 200 行索引,早期曾涨到 50 万 tokens)。
运动很贵:故事板一帧大约 50 毫秒,成品 1 秒大约 8–40 秒。所以先 storyboard → animatic → production。空间反馈用 Paper 画布指,而不是在 Slack 里描述「左边那个」。主代理当 chief of staff:拆任务、开异步子代理、按复杂度选模型和 effort,公开前要人批。过夜重皮 52 页幻灯的例子:主代理大约跑 1 小时,子代理合计超过 6 小时,对话不阻塞。
成本从约 8 美元掉到约 50 美分,原文没有给出「每一分钱由哪一项省下」的拆账表。文中并列出现、不宜单点归因的机制包括:迁到 Managed Deep Agents 后自有代码约缩 80%、按需加载工具与 job-specific skills、共享 wiki、确定性 gate、故事板先行、持久 project folder、异步子代理与按任务选模型,以及模型变强后删硬规则。caching 原文未当作降本主因单独列出。
快环和慢环:反馈怎么进系统
没有记忆的话,每个新线程都从零开始。他们做了两层学习。快环:有人当场说出规则或偏好,当轮就写入 memory 文件;团队共享标准优先于个人偏好,公司频道跟公司 voice。慢环:每单结束后 learn_from_job 拉起轻量子代理,最多抓 5 条有证据的教训挂到对应 skill;后续任务会读、会打分,每周再有背景代理把有用的晋升进 skills / wiki。
这和「把设计师关在评审线程里口头改图」不一样。判断被收进共享环境,agent 才能学第二次。早期 AGENTS.md 一度涨到约 50 万 tokens,后来收成约 200 行索引——上下文也会自己发胖,要有硬上限。
开源了什么,没替你保证什么
Repo 给的是 harness:sandbox 电脑、skills、wiki、memory、异步子代理、Slack UX。Fork 之后要自己加品牌 tokens、字体和 skills,再用 Managed Deep Agents 部署。原文是厂商复盘,没有独立实测、没有公开失败案例库;深度调教等中文转写也标了这一点。写进你们团队时,先当工程手册读,再当案例宣传读。
今天就能做的 4 件事
对照原文写法,不必先 fork 整仓:
-
打开你们的 AGENTS.md / skills,标出哪些条目是在补当前模型的短板;模型升一档后,排一期删除评审。
-
把「必须永远成立」的顺序和不变量迁出 prompt,写成代码或 CI gate(过审才能组装、过 lint 才能出图)。
-
设计师反馈只记改法不够,补一句 reasoning;可测的错误另开自动检查。
-
贵渲染前先强制便宜的 storyboard / 规格确认;小改走中间表示,不整资产重生。
我观察一句,只作桥,不作这篇的主证据:我们以为出自我们的结论,实际上常常出自 agent,世界就更容易趋同。默认写在 skill、wiki 和门禁里的东西,决定了「像谁」。LangChain 这篇的用处,是把那层默认变成可改、可删、可审计的 harness——价值在工具、工作流和 gates,不在再宣称做了一个 agent。
原文:https://www.langchain.com/blog/design-agent
开源:https://github.com/langchain-ai/design-agent
🔗 链接
首发于 X(2026-10-28):同题短帖;中文长文公众号/知乎/小红书排程 2026-10-29。