工程实践
Meta 的路由 7 步,只有 1 步用 LLM
Meta 给推荐系统数据管道做的 agent,最后靠的是一个 1300 行的路由:它把 20 多个 workflow(固定的工作流程)派给 14 个 subagent(只管一块的子 agent),自己一点领域工作都不做。
 Stometa
Meta 给推荐系统数据管道做的 agent,最后靠的是一个 1300 行的路由:它把 20 多个 workflow(固定的工作流程)派给 14 个 subagent(只管一块的子 agent),自己一点领域工作都不做。
这是 Plawan Rath、Akhil Jindal、Ashwini Verma 10 月 19 日在 Meta Engineering 发的复盘《The Thin Orchestrator》。他们第一版是一个 agent 装下全部知识,demo 能跑,上了生产就开始幻觉,最后的办法是给中间那个 agent 减活。
我读的时候一直在对照自己那几个 bot。结构上挺像,差的那块正好是 Meta 最看重的。
一个 agent 装下全部知识,哪里出了问题?
他们要自动化的是「新增一个数据列」的上线流程。这件事跨 3 个代码库、3 种语言,最多 6 个流水线阶段,各阶段还要保持同步。第一版 agent 装了配置 schema(配置的结构定义)、代码生成规则、路由逻辑、校验要求,还有 10 多个数据源各自的填充模式。
原文说,上下文过了某个量以后,多给知识反而让效果变差。agent 会串味,把一个子系统的字段命名规则用到另一个上,或者拿给 A 数据源的代码生成模式去填 B。
他们还试过另一种单 agent 方案。工程师给每个任务手写 system prompt(系统提示词),成功率 70–80%;不手写,掉到 10–20%。原文把这归到架构上,不算 prompt 的问题。
路由只做 7 步,6 步是确定性的
路由和 subagent 怎么分工
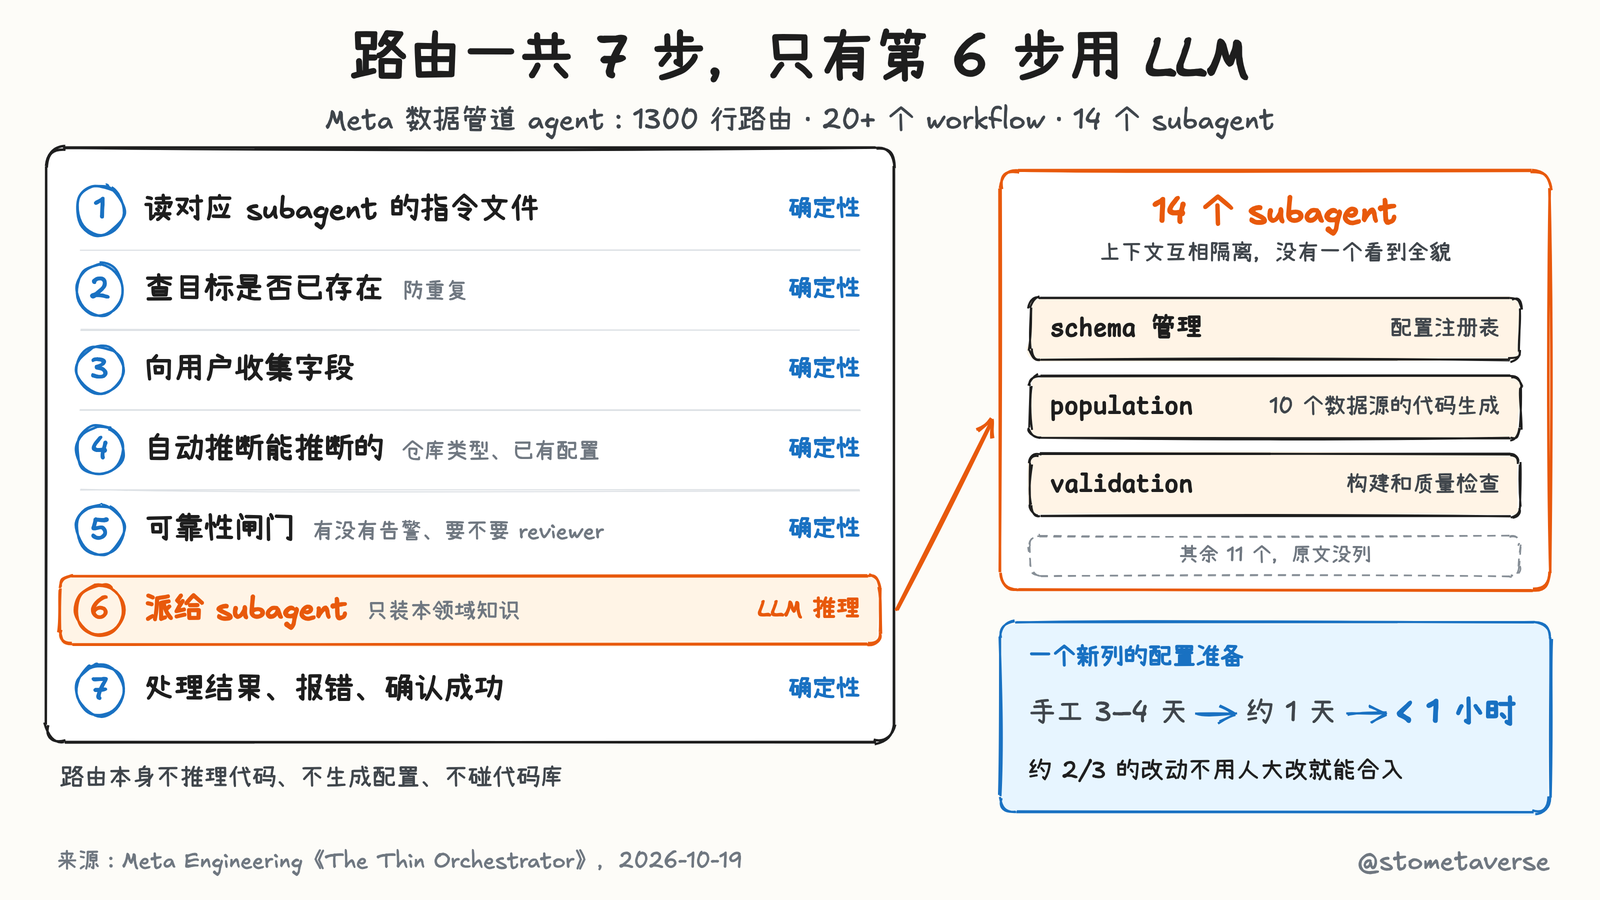
路由只做四件事:识别意图、收集必填字段、跑可靠性检查、派给对应的专家。它不推理代码,不生成配置,也不碰代码库。
14 个 subagent 各管一块,上下文互相隔离。原文只举了三个:schema 管理 agent 管配置注册表,population agent 管 10 个数据源各自的代码生成,validation agent 管构建和质量检查。原文的说法是,没有一个 agent 看到全貌,这是特性。
固定协议的 7 步
-
读对应 subagent 的指令文件
-
查目标是否已经存在,防止重复
-
向用户收集字段
-
自动推断能推断的,比如仓库类型、已有配置
-
可靠性闸门:有没有正在生效的告警,要不要指定 reviewer(审核人)
-
派给 subagent
-
处理结果、报错、确认成功
前 5 步和第 7 步是确定性流程;第 6 步只是把任务交给 subagent,LLM 推理发生在只装了本领域知识的 subagent 里,路由本身不用 LLM。
原文有一句我很认同,我的翻译是:
「这件事归哪个 subagent」是路由决策,不是推理任务,别用 LLM。
原文:"Which subagent handles this?" is a routing decision, not a reasoning task. Don't use an LLM for it.
它给的办法是关键词匹配、意图分类、收集字段。
加新用例,为什么不用写新 agent?
他们把「要做什么」和「每步怎么做」拆开了。workflow 模板是确定性的状态机,比如「列上线」是 Schema→Validation→Population→Testing。
要支持管道迁移这个全新用例时,他们只写了一个新模板,把已有的 agent 换个顺序串起来,没写一行新 agent 代码。
每个 subagent 都是同样的 5 块:知识来源、派活前清单、步骤、发现模式(去 monorepo,也就是所有代码放在一起的大仓库里,找相关代码的办法)、排错表。原文说第 15 个 subagent 和第 1 个长得一模一样。知识文件有 25 份以上,运行时按需加载,改完下次会话就生效,路由不用动。
效果是这样的:
一个新列的配置准备用时手工3–4 天旧的配置驱动系统约 1 天现在不到 1 小时
另外,大约 2/3 的改动不需要人大改就能合入。
拿它对照我自己的几个 bot
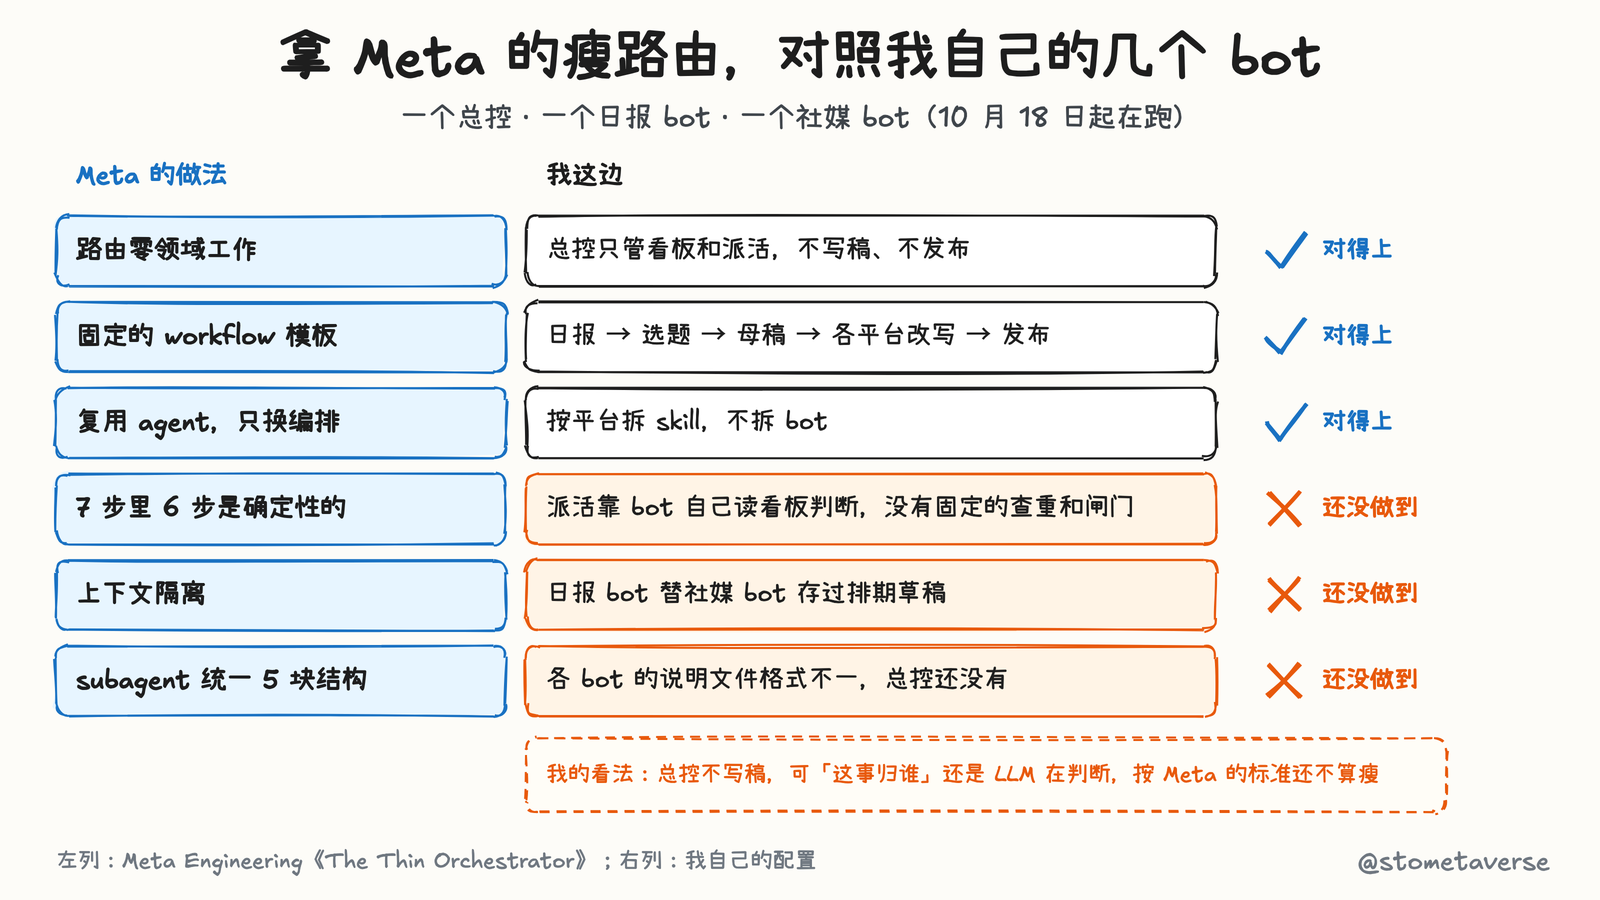
我从 10 月 18 日开始用几个 bot 分工跑内容:一个总控,一个日报 bot,一个社媒 bot。
总控只维护一块共享看板、派活,不写稿也不发布。日报 bot 每天早上出日报,我挑中的选题它写进选题文件。
社媒 bot 从选题写稿、改各平台版本、排期,每天还给日报打分,日报 bot 第二天先读这份评估再开跑。
流程是固定的:日报、选题、母稿、各平台改写、发布。按平台拆的是 skill(写给 bot 的操作说明),不是 bot。
能对上的三处
总控不干领域活,对应「路由零领域工作」。日报到发布这条线,就是一个 workflow 模板。按平台拆 skill 不拆 bot,对应「复用 agent、只换编排」。
还差的三处
第一,派活没有确定性步骤。现在派活和接活,全靠 bot 自己读看板判断,Meta 第 2 步的查重、第 5 步的闸门,我这边都还没写成固定检查;已有的用户审阅规则仍靠 bot 读到并遵守。我的判断是:总控不写稿,可「这事归谁」还是 LLM 在判断,按 Meta 的标准它还不算瘦。
第二,上下文隔离有漏洞。有条推文草稿按我们自己的规则该由社媒 bot 存进排期工具,结果是日报 bot 顺手存的;看板上也有发布记录是日报 bot 代做的,还有几条任务同时写了两个负责 bot。
第三,说明文件不统一。各 bot 的职责文件格式不一样,总控自己的还没写。
有一道闸门是 10 月 20 日刚加的:任何内容存进排期工具之前,先把成稿给我看。它对应 Meta 的第 5 步,只是现在写在规则文件里,靠 bot 读到并遵守,还不是一步固定检查。
这套做法的代价,和原文没说的
文中那组 65.3% 对 16.6% 不是 Meta 测的。它来自 Meta 引用的一项 Mount Sinai 研究(Meta 原文称预印本),测的是临床检索、信息抽取、剂量计算这类任务:80 个任务一批时,多 agent 编排准确率 65.3%,单 agent 掉到 16.6%,token 最多省 65 倍。Meta 没给自己多 agent 方案的成功率,所以没有单 agent 和多 agent 的同口径对比。
按原文约 2/3 的表述推算,剩余约 1/3 仍需要较多人工修改。原文说用通用性换领域深度是有意的取舍。往后的自动改进,原文写的是始终由人审把关。
规模也不一样。14 个 agent、20 多个 workflow 是 Meta 的量,我这边就几个 bot。我更想先抄的是那几步确定性检查,成本低,bot 数量先不动。
今天就能做的 3 件事
这三条都出自原文最后的「How to Apply」:
-
把编排层的每一步列出来,标上「确定性」还是「要 LLM 推理」。判断归谁处理的那步,能用关键词、意图分类、字段收集解决的,就别交给 LLM。
-
给每个 subagent 用同一套结构写说明:知识来源、派活前要齐的输入、步骤、常见故障。
-
下次想加新 agent 之前,先看能不能把现有的 agent 换个顺序串起来。
你的编排层里,有几步其实不需要 LLM?
🔗 链接
-
Meta Engineering《The Thin Orchestrator: How We Made Our AI Agents More Reliable by Giving the Router Less to Do》(2026-10-19,Plawan Rath、Akhil Jindal、Ashwini Verma):https://engineering.fb.com/2026/10/19/ml-applications/thin-orchestrator-ai-agent-architecture/
-
65.3% / 16.6% 的出处,Mount Sinai 研究《Orchestrated multi agents sustain accuracy under clinical-scale workloads compared to a single agent》(npj Health Systems,2026-03-09):https://www.nature.com/articles/s44401-026-00077-0
本文为对 Meta 原文的阅读与解读,事实与数字以原文为准,观点部分为个人判断;配图为作者手绘重绘。
首发于 X(2026-10-24,scheduled):原文