AI 工具
我把 OpenViking 自部署成所有 Agent 的记忆层:它和向量 RAG 记忆到底差在哪
OpenViking(火山引擎开源)换了个思路:把知识、记忆、技能统一放进一个 viking:// 虚拟文件系统。我把它自部署在一台 40 核服务器上,当 Claude Code 和 Codex 的共享记忆层。
 Stometa
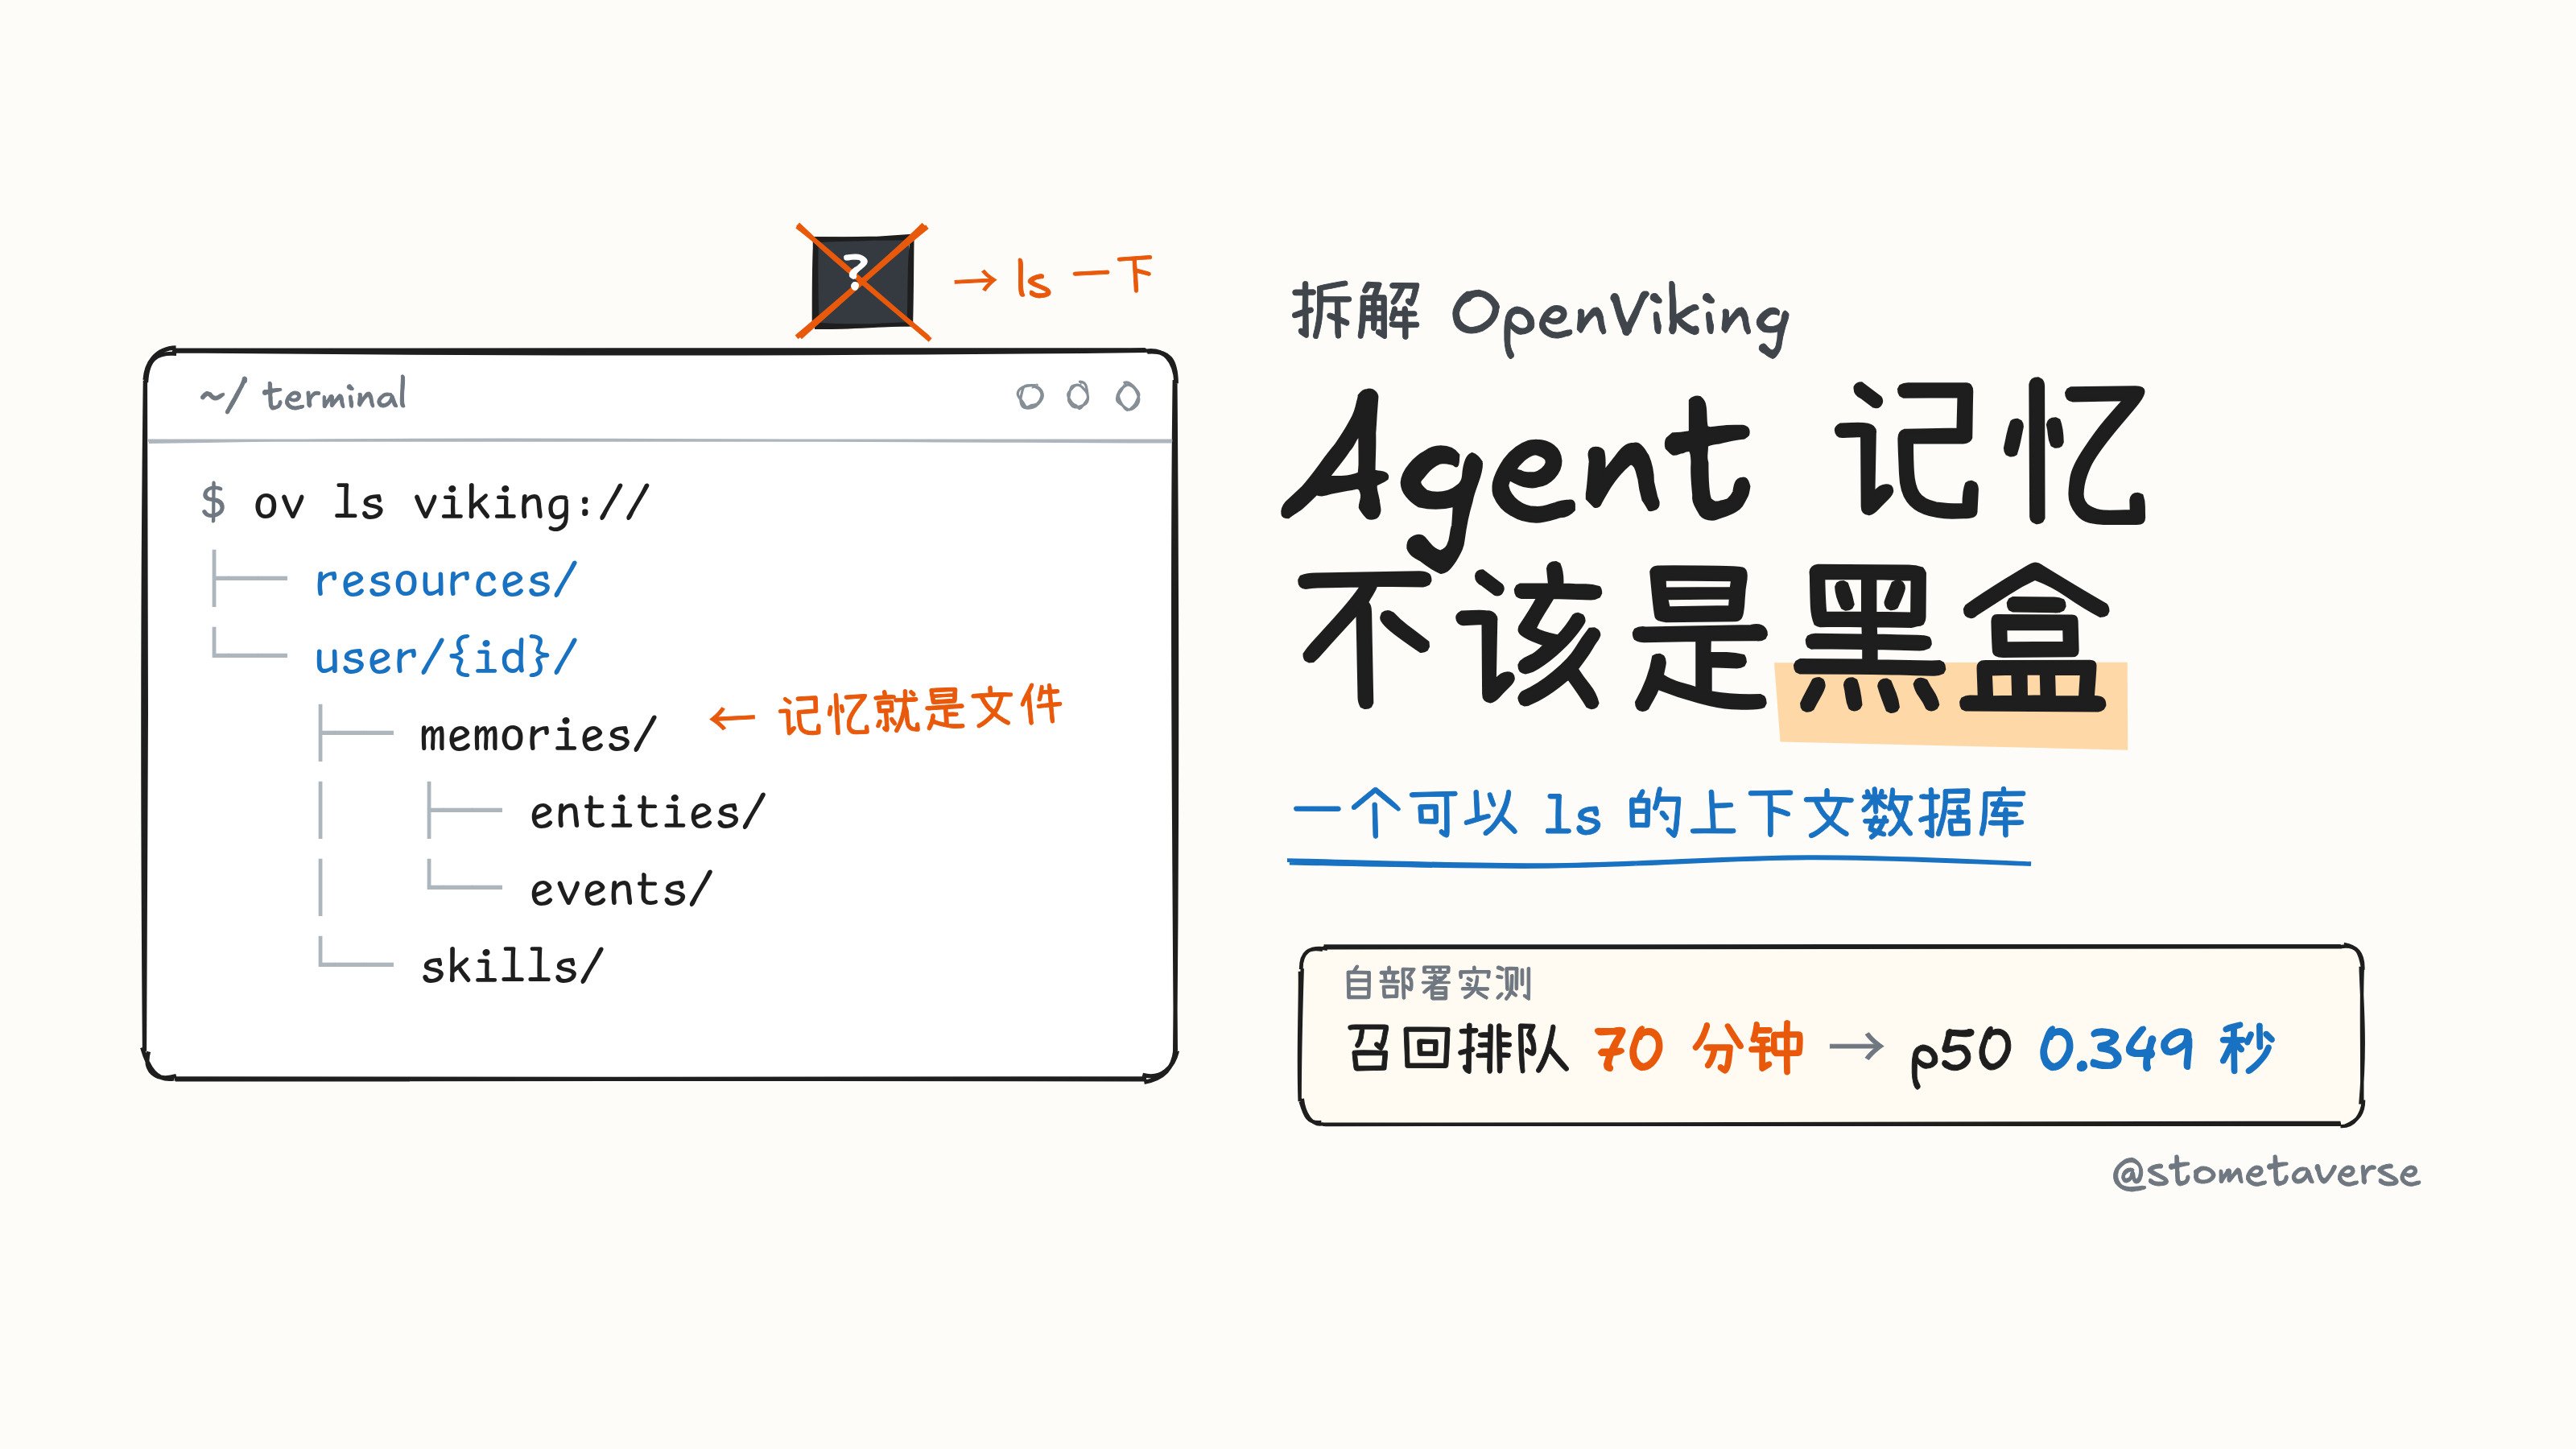
先说结论:如果你的 Agent 记忆还是「把聊天切块塞进向量库」,OpenViking 值得认真看一眼。
今天大多数 Agent 记忆是黑盒:文本进去,向量出来,没人说得清它到底记住了什么、哪条已经过期、谁能看。
OpenViking(火山引擎开源)换了个思路:把知识、记忆、技能统一放进一个 viking:// 虚拟文件系统。Agent 像操作文件一样 ls、tree、read、grep,人也能打开目录直接看、直接改。
这篇不是看完 README 写的。我把它自部署在一台 40 核服务器上,当 Claude Code 和 Codex 的共享记忆层。最惨的时候,一次召回排队 70 分钟;跑了 14 轮测试、4 次正式安装,热查询 p50 修到了 0.349 秒。
下面是我用下来的理解,尽量只讲文档里对得上的东西。
🧭 一句话讲清楚
OpenViking 是给 AI Agent 用的「上下文数据库」。
它管三类东西:
- Resource(资源):文档、代码仓库、网页
- Memory(记忆):偏好、实体、事件、经验
- Skill(技能):用
SKILL.md描述的做事流程
三类东西都有自己的 viking:// 地址,都能被检索、浏览、编辑。
可以这么理解:向量库负责「找得到」,文件系统负责「读得懂、改得动」。OpenViking 把两者合在一起,再加上自动摘要、记忆提取和权限。
❓ 为什么需要它
Agent 跑长任务,最常见的三种「失忆」:
- 昨天确认过的约束,今天又要重说一遍
- 记忆越攒越多,重复、冲突、过期的混在一起
- 一次召回塞进一堆 chunk,token 烧了,关键信息还没命中
问题往往不在模型,而在记忆层本身:
- 存进去的是看不见的向量
- 更新只能追加,旧的不会被合并
- 读取只有「整块塞进上下文」一种粒度
官方给过一组数据(0.3.22 版本,LoCoMo 长对话记忆测试):接入 OpenViking 后,OpenClaw、Hermes、Claude Code 三个 Agent 的准确率都落在 80–83%,它们原生记忆是 24–57%;输入 token 降低 34.3–91.0%。
这是官方 benchmark,我没有复现,仅供参考。
🏗️ 整体架构
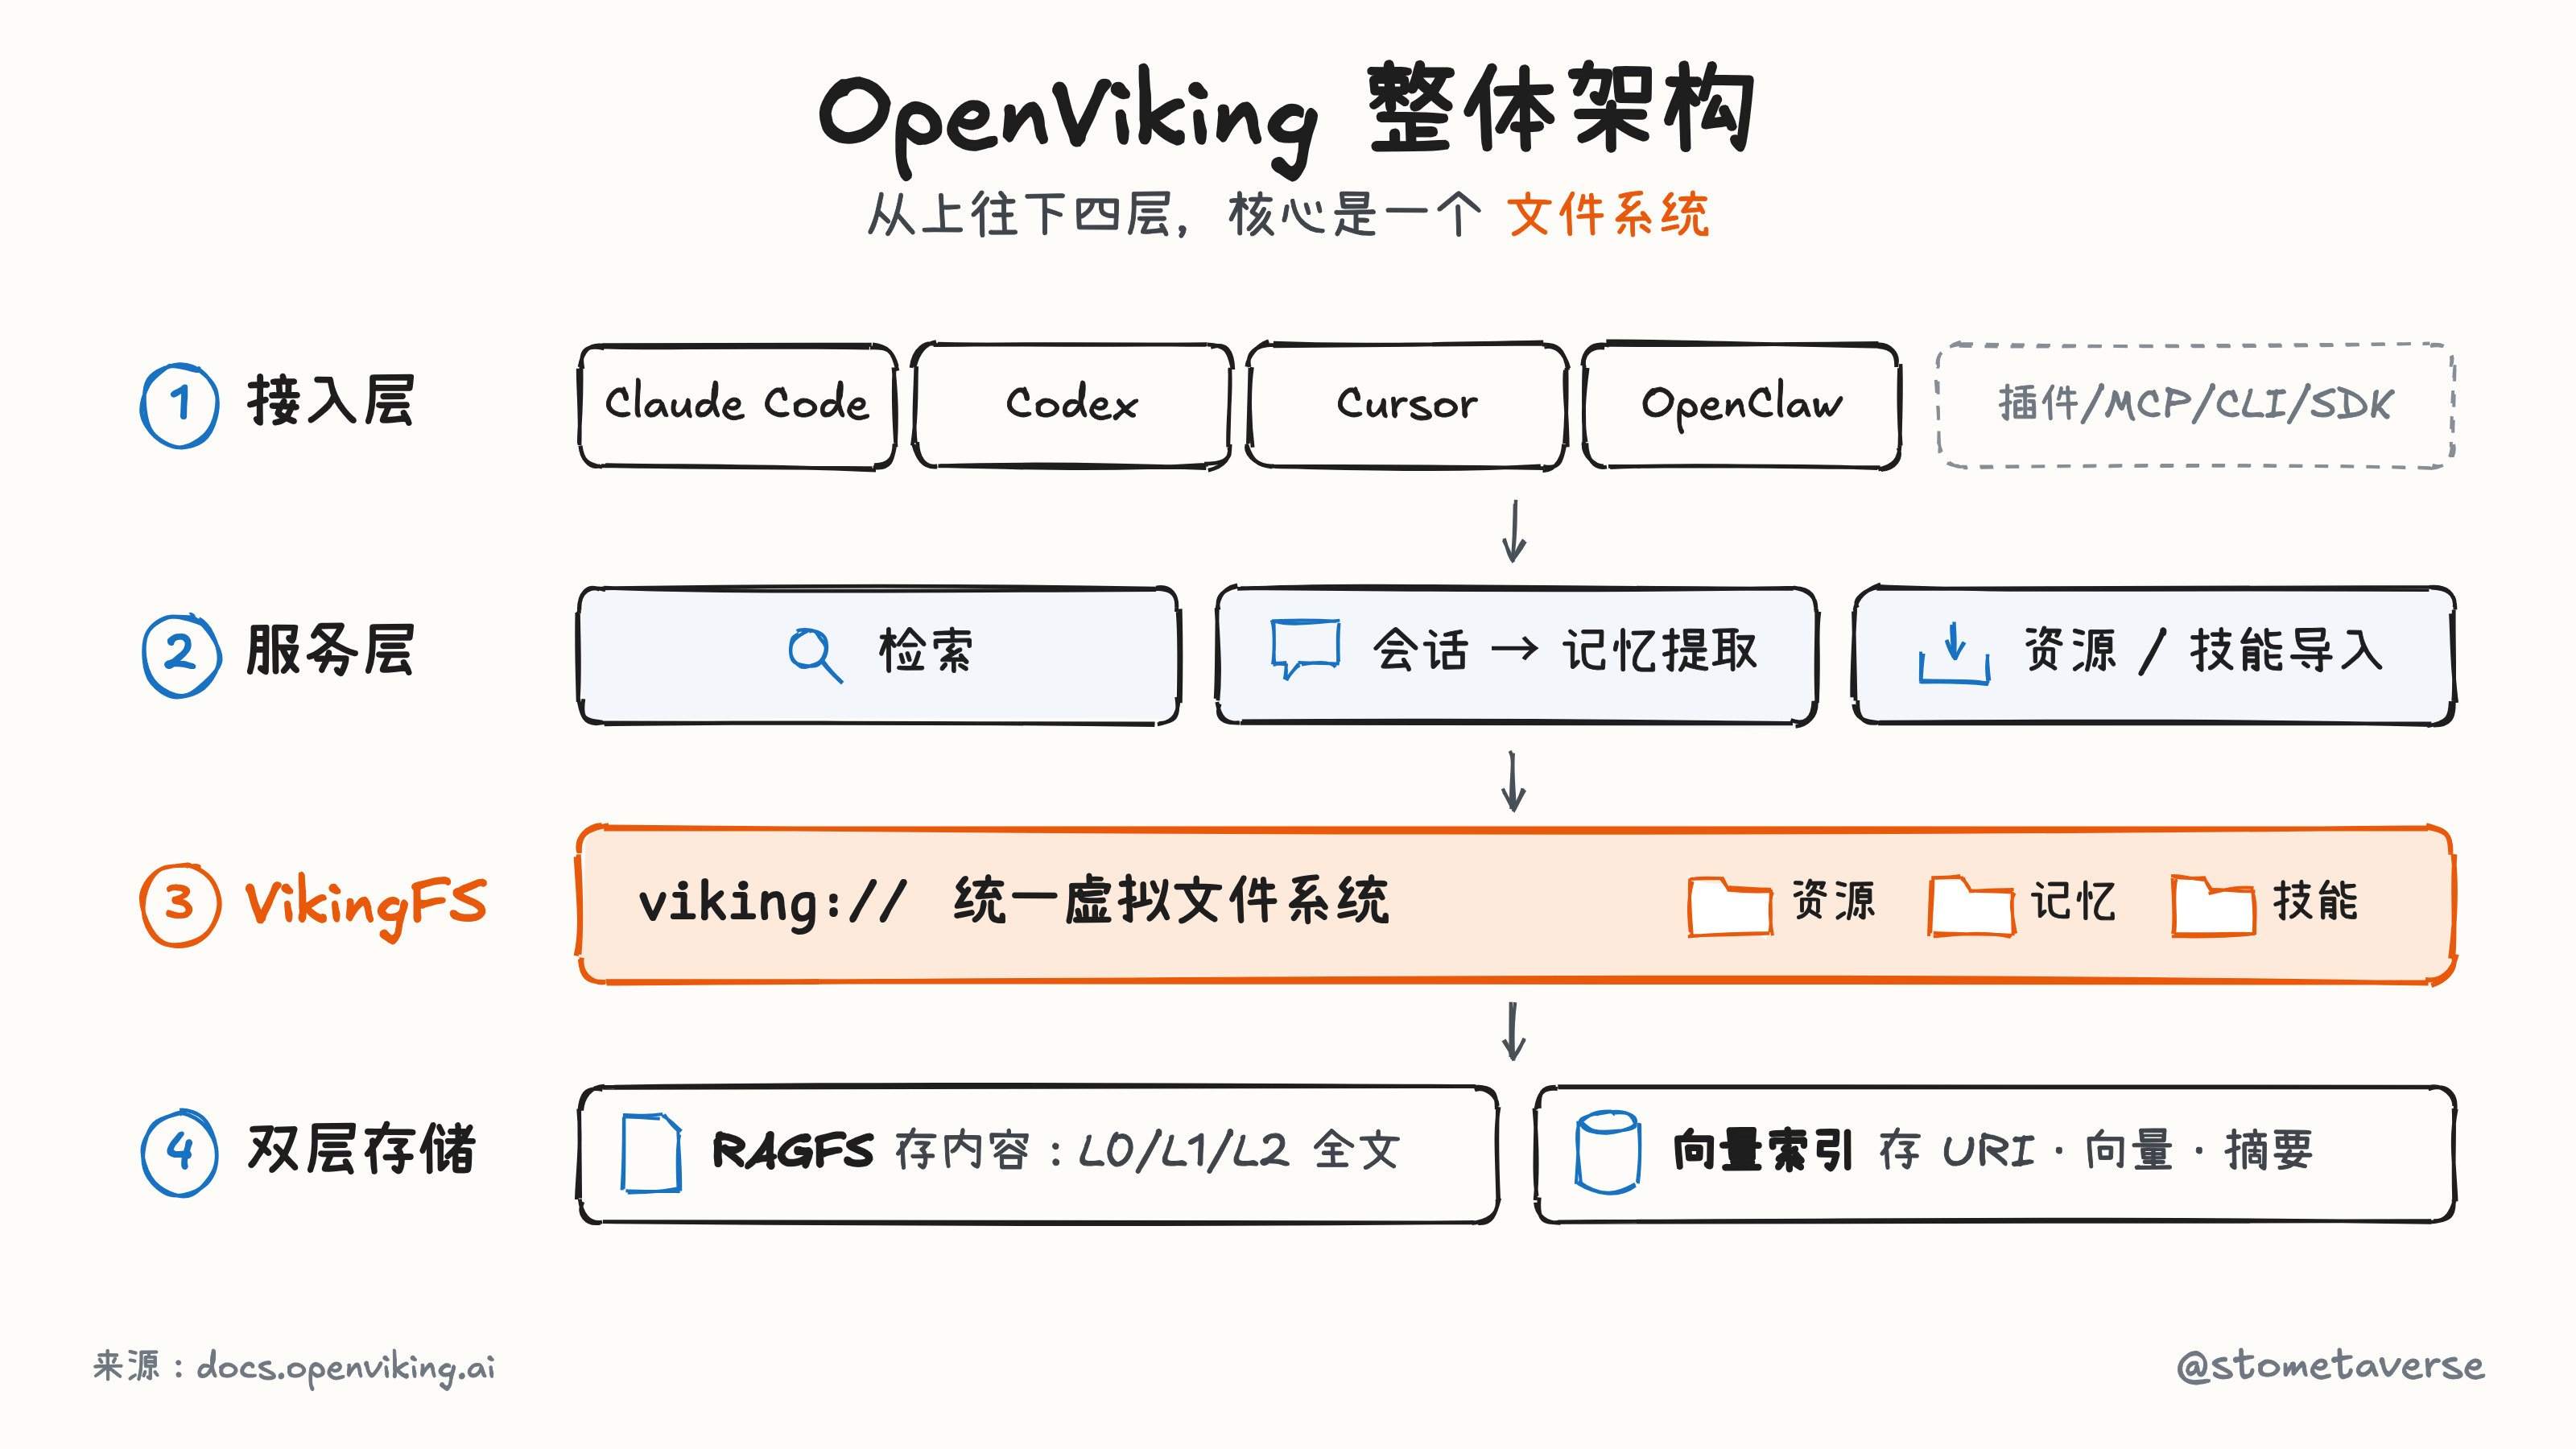
从上往下四层:
- 接入层:Claude Code、Codex、Cursor、OpenClaw 等,通过插件 / MCP / CLI / SDK / HTTP 接入
- 服务层:三条主线——检索、会话(记忆提取)、资源与技能导入
- VikingFS:统一的 viking:// 虚拟文件系统
- 双层存储:RAGFS 存内容(L0/L1/L2 全部正文),向量索引存 URI、向量、元数据和摘要
三条数据流:
- 加资源:解析 → 建目录树 → 写入 → 异步自底向上生成 L0/L1 → 建索引
- 检索:(可选)意图分析 → 向量检索 → (可选)Rerank
- 会话提交:归档 → 按记忆 Schema 提取 → 合并写回
🧩 Entity & Event:记忆不是一堆同质的文本
OpenViking 的记忆是有类型的。
内置类型包括 profile、preferences、entities、events、cases、experiences 等,每种类型有自己的 Schema 和目录。
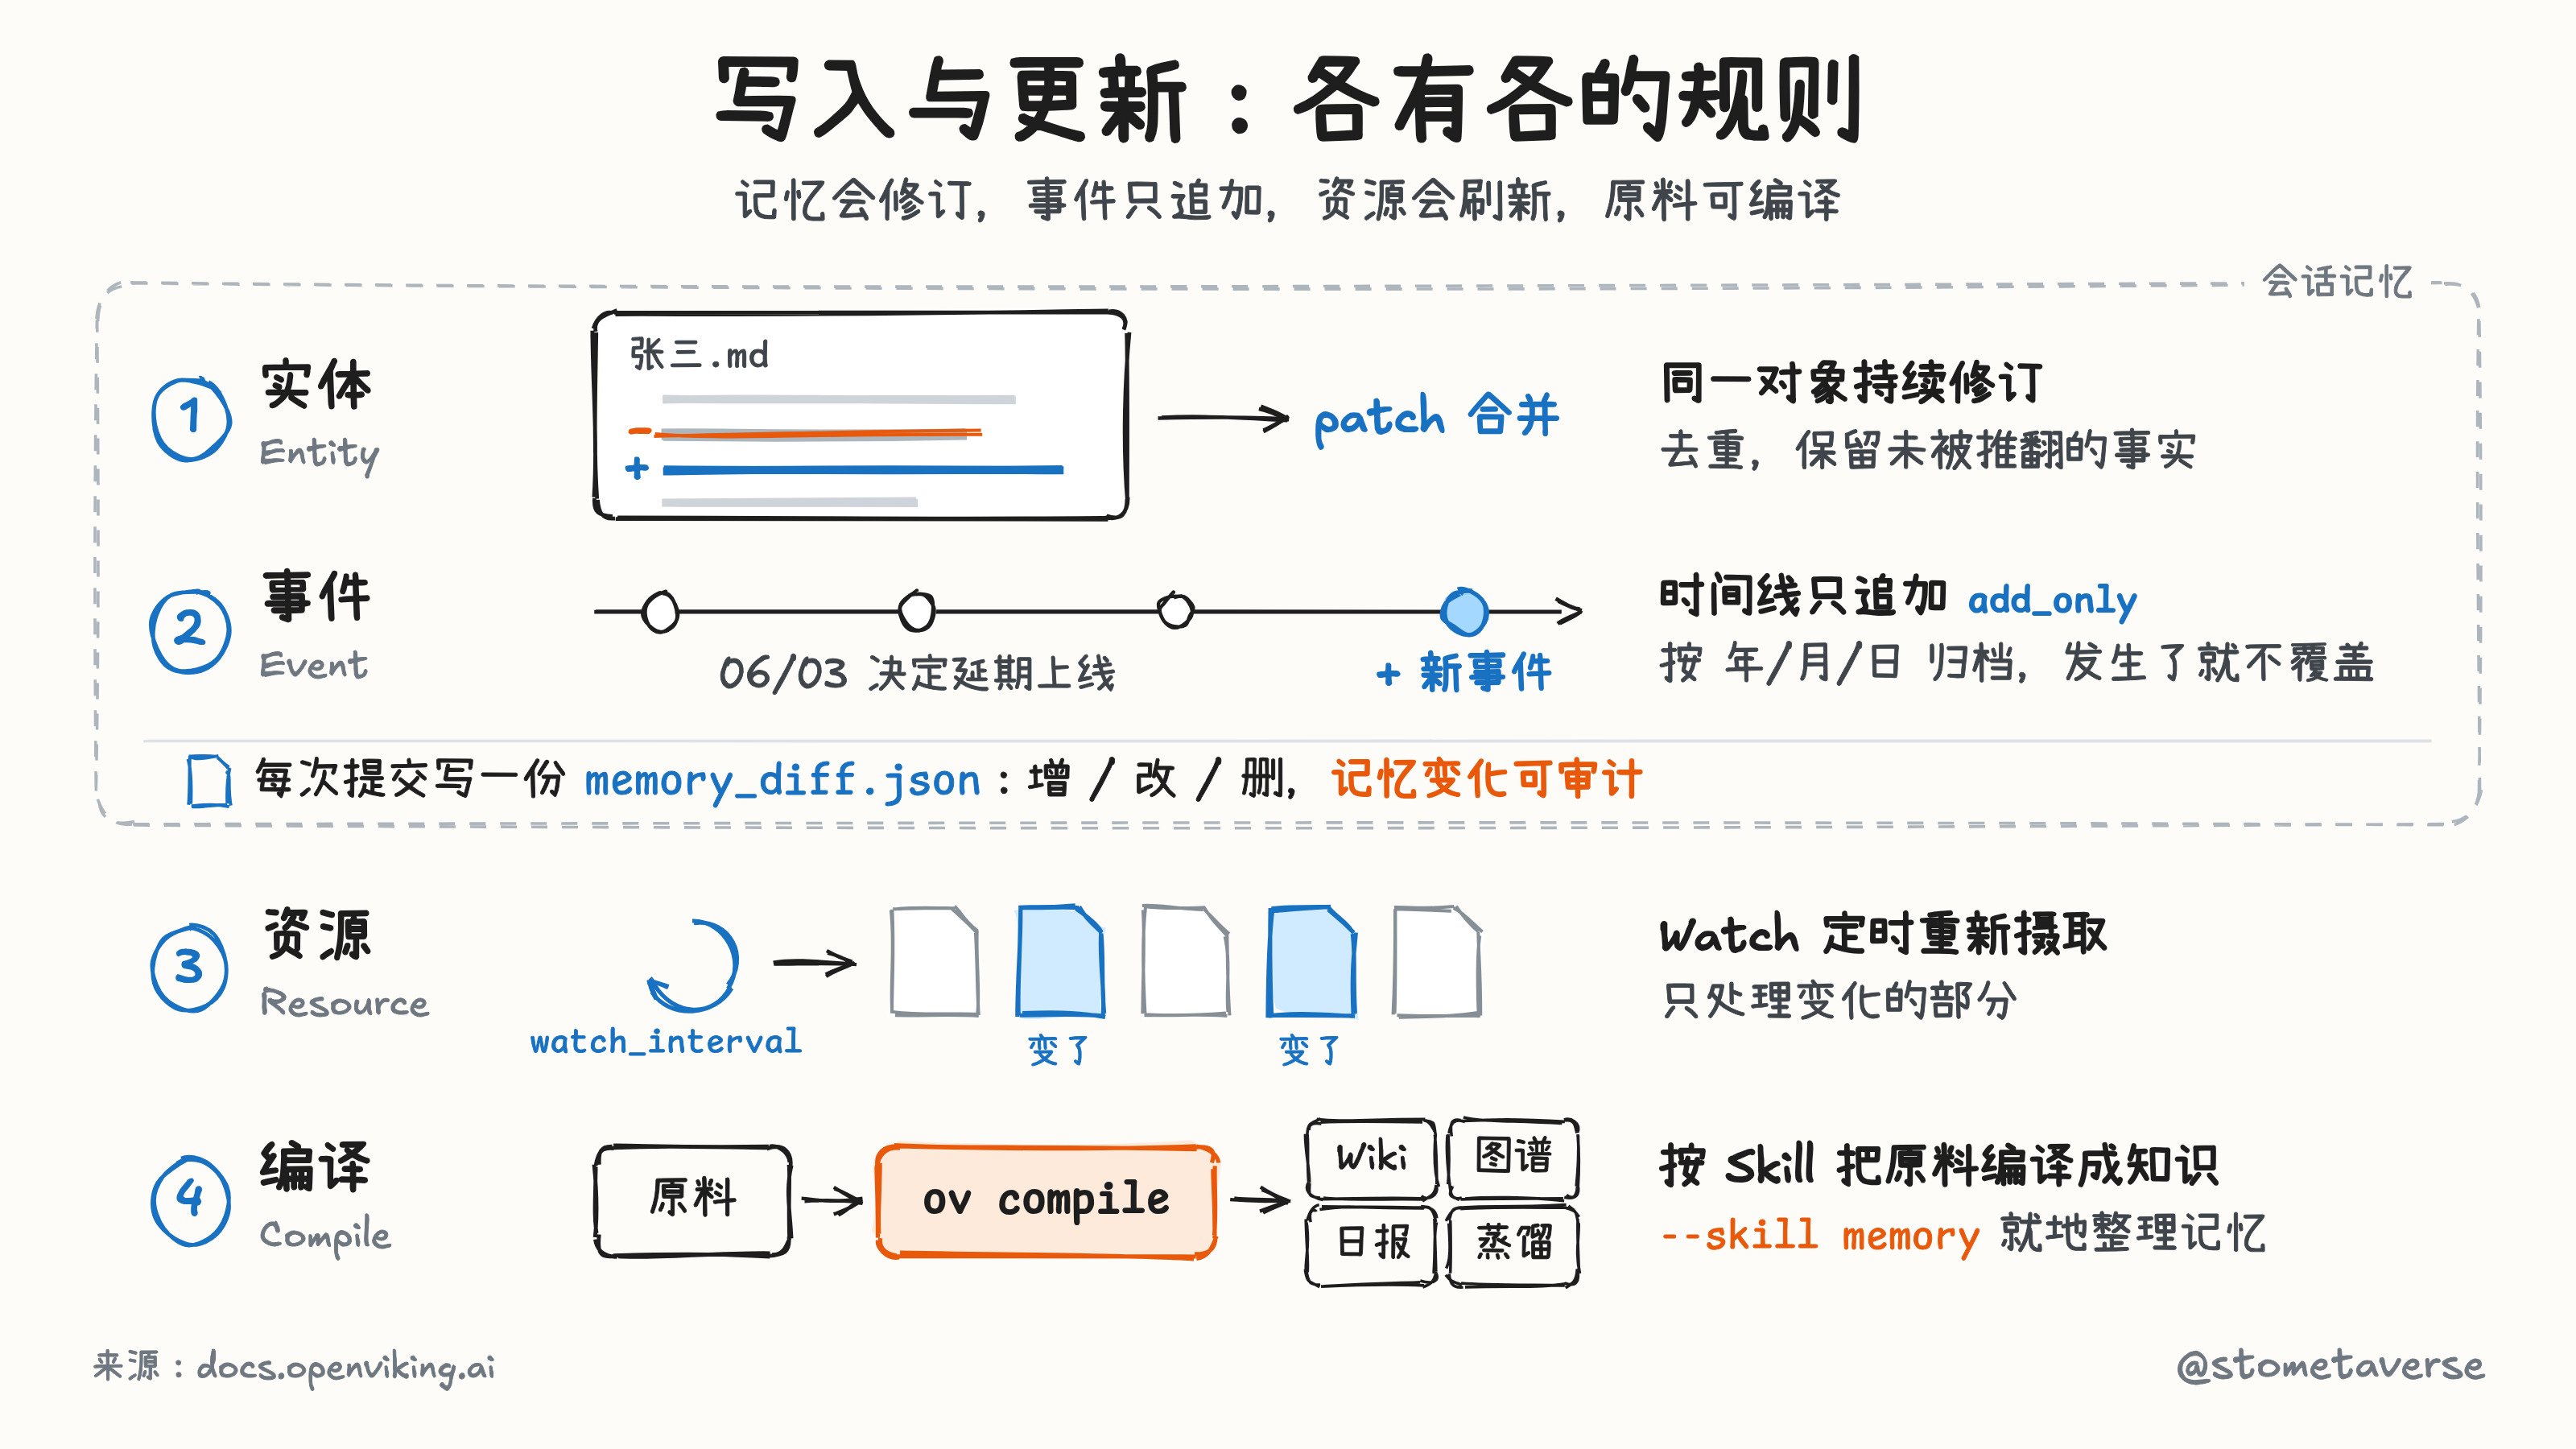
最值得说的是 Entity 和 Event——它们的更新规则正好相反。
Entity(实体)= 一张会被持续修订的卡片
- 人物、项目、组织、产品、地点……每个实体一个 Markdown 文件,按「类别/名称」存放
- 新信息进来时做 patch 合并:去掉重复或同义的事实,保留其他已有事实,除非被新信息推翻
- 只合并「明确是同一对象的别名」,主题相近、长得像的不合并
Event(事件)= 一条只追加的时间线
- 每个事件是原子的:一次决定、一个承诺、一个进展、一个结果
- 按「年/月/日」目录归档,「昨天」这种相对时间会被换算成具体日期
- 默认模板是 add_only 模式,事件名和对应的消息范围不可变
为什么重要?
「张三是谁」应该被不断修正成最新版本;「6 月 3 日决定延期上线」发生了就是发生了,不该被后来的信息覆盖。
纯向量记忆把这两种东西当成同一种 chunk。OpenViking 把它们分开建模。
还有一个细节:每次会话提交,都会在归档目录写一份 memory_diff.json,记录这次新增、修改、删除了哪些记忆,以及哪些操作被校验跳过。
记忆的变化,可以审计。
🔄 Resources:资源怎么保持新鲜
资源是你主动喂给 Agent 的外部知识:产品手册、API 文档、代码仓库、飞书文档、网页、sitemap/RSS……
更新有两条路:
- Watch 定时刷新:导入 URL、Git、sitemap 这类能重新读取的来源时,设一个 watch_interval(分钟),到期自动重新摄取;可以暂停、恢复、手动触发
- 重新导入到同一个目标:导入结果落在原目标上时,语义和向量处理会复用没变的内容,只处理变化的部分
注意:本地文件上传是一次性快照,不能 Watch。本地内容变了,要重新导入。
上层摘要也会跟着变:子目录摘要变化后,父目录的 L0/L1 按 freshness 阈值向上刷新。还没刷新的目录依然可读,并会标出「有多少变化尚未反映」。
📚 L0 / L1 / L2:先看摘要,再读原文
这是 OpenViking 最直观的设计。
每个经过语义处理的目录,带两个隐藏文件:
- L0:
.abstract.md,一句话摘要(默认预算 256 字符),用于向量检索、快速过滤 - L1:
.overview.md,概览和导航(默认预算 4000 字符),用于 Rerank、决定要不要往下读 - L2:原始文件或解析后的正文,没有统一上限,需要时才读
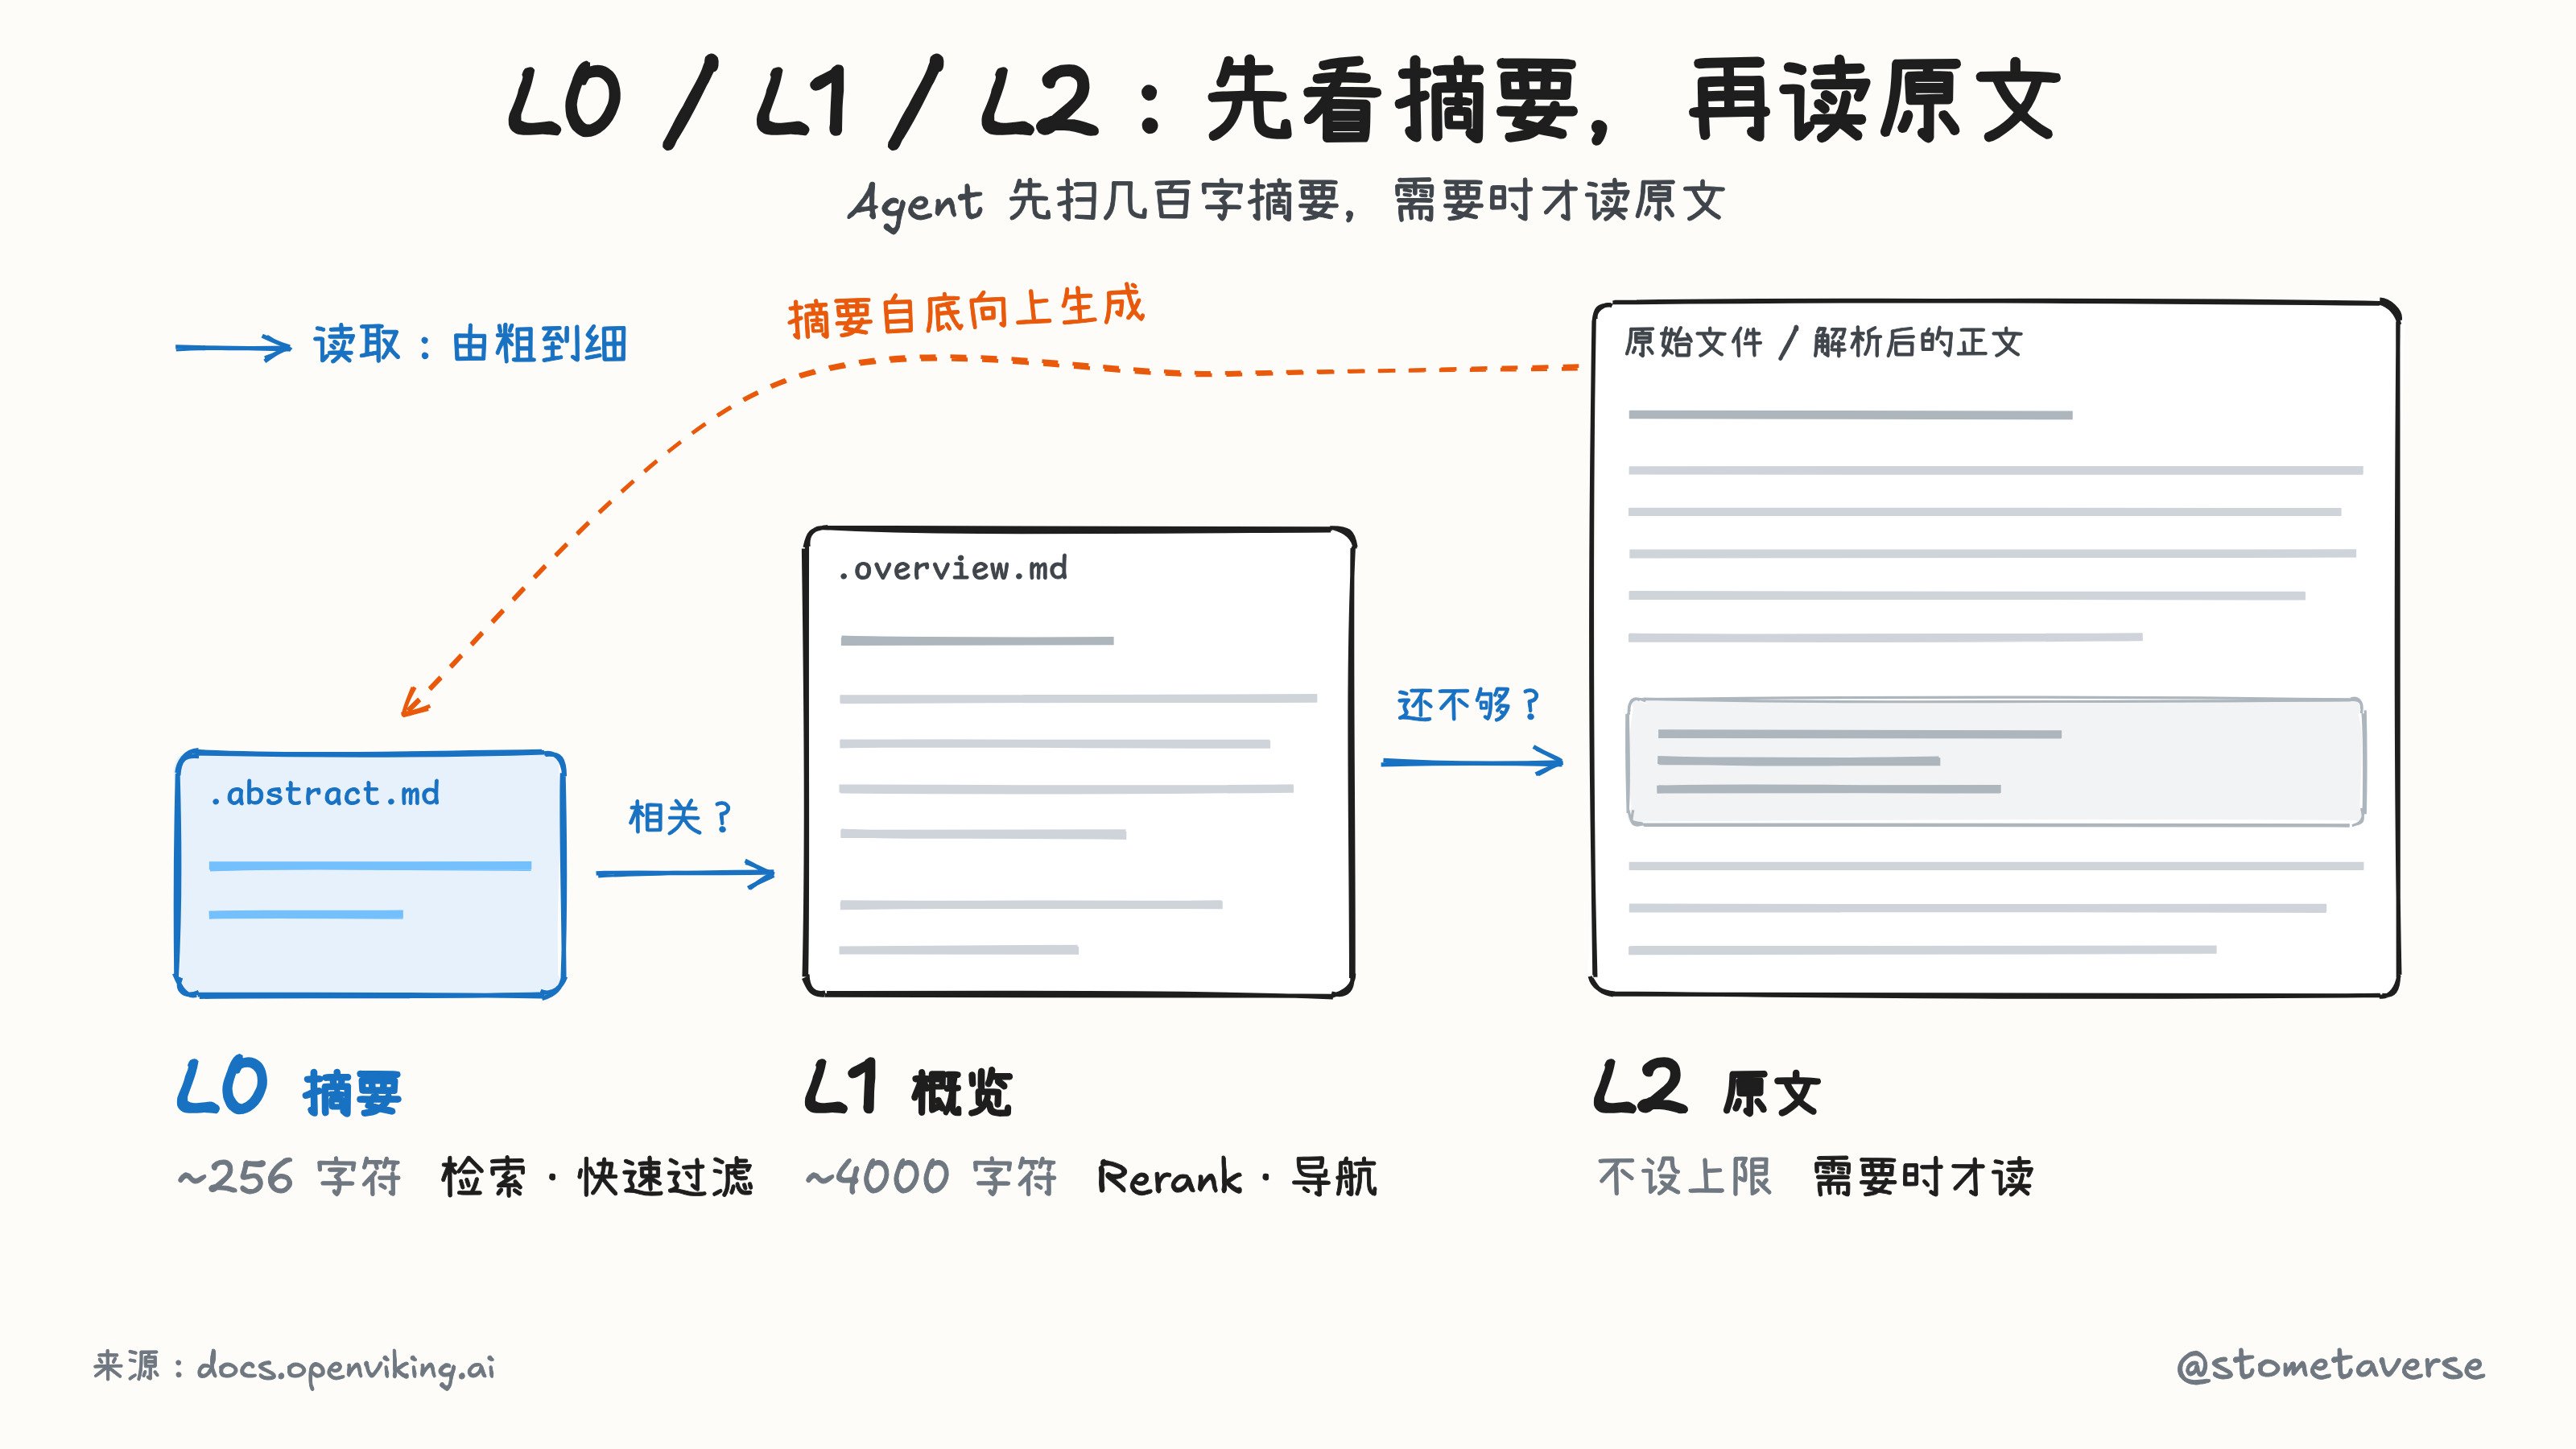
摘要是自底向上生成的:文件摘要 → 叶子目录 → 父目录。
好处很朴素:Agent 先扫几百字的摘要判断相关性,而不是一上来就把整个文档塞进上下文窗口。官方把它列为节省 token 的核心手段。
一个容易误解的点:L0/L1 是「目录级」的,不是每个文件都配一份。文件摘要会被汇总进所在目录的 L1。
⚙️ Compile:把原料编译成知识
ov compile 读取 OpenViking 里的文档、笔记、网页或会话记录,按指定的 Skill 整理成新产物,再写回 OpenViking。
三个参数:--from 来源、--to 输出目录、--skill 用哪个 Skill。
仓库自带的 Skill 示例:
- LLM Wiki:一套互相链接的 Markdown 页面 + 导航 index
- Knowledge Graph:
entities/*.md节点 +relations.jsonl关系表 - 日报:每天一页,还原「这天到底做了什么」
- 知识蒸馏:跨来源提炼主题结论
还有一个特殊模式:--skill memory。它对已有的记忆目录做就地整理:去重、合并、拆分、精简。
比如模型在不同批次里没认出「阿珍」和「陈静娴」是同一个人,你可以用 --instruction 点破,让它合并。
前提:Skill 编译需要服务端配置 Agent Runtime(本地可以用内置的 VikingBot,启动时加 --with-bot);记忆整理模式不需要。
我的理解:记忆提取是「增量写入」,compile 是「定期重构」。两者配合,记忆库才不会越用越乱。
🔐 ACL 与企业级
一个人用,记忆随便放。一个团队共用,权限就是硬需求。
OpenViking 分三层:
- 多租户:account 是最外层边界,不同 account 的数据默认完全隔离;account 内用 user 隔离个人记忆和会话;角色分 ROOT / ADMIN / USER
- ACL:在同一个 account 内,把共享资源目录或文件授权给某个用户或用户组,权限分 read / write / manage
- 继承:类似协作文档,目录授权默认作用于所有子孙;某个子目录可以设成 restricted,切断上级的继承
几个要注意的点:
- ACL 只作用于共享资源 viking://resources/...,个人私有区不接受 ACL
- 账号级 ACL 开关默认关闭,需要主动开启
- 检索结果会按 ACL 过滤;但权限变更随索引更新生效,文档明确说不保证强一致
官方博客里有句话我很认同:目录名和 prompt 约定,都不是访问控制。
⚖️ 和普通向量 RAG 记忆的对比
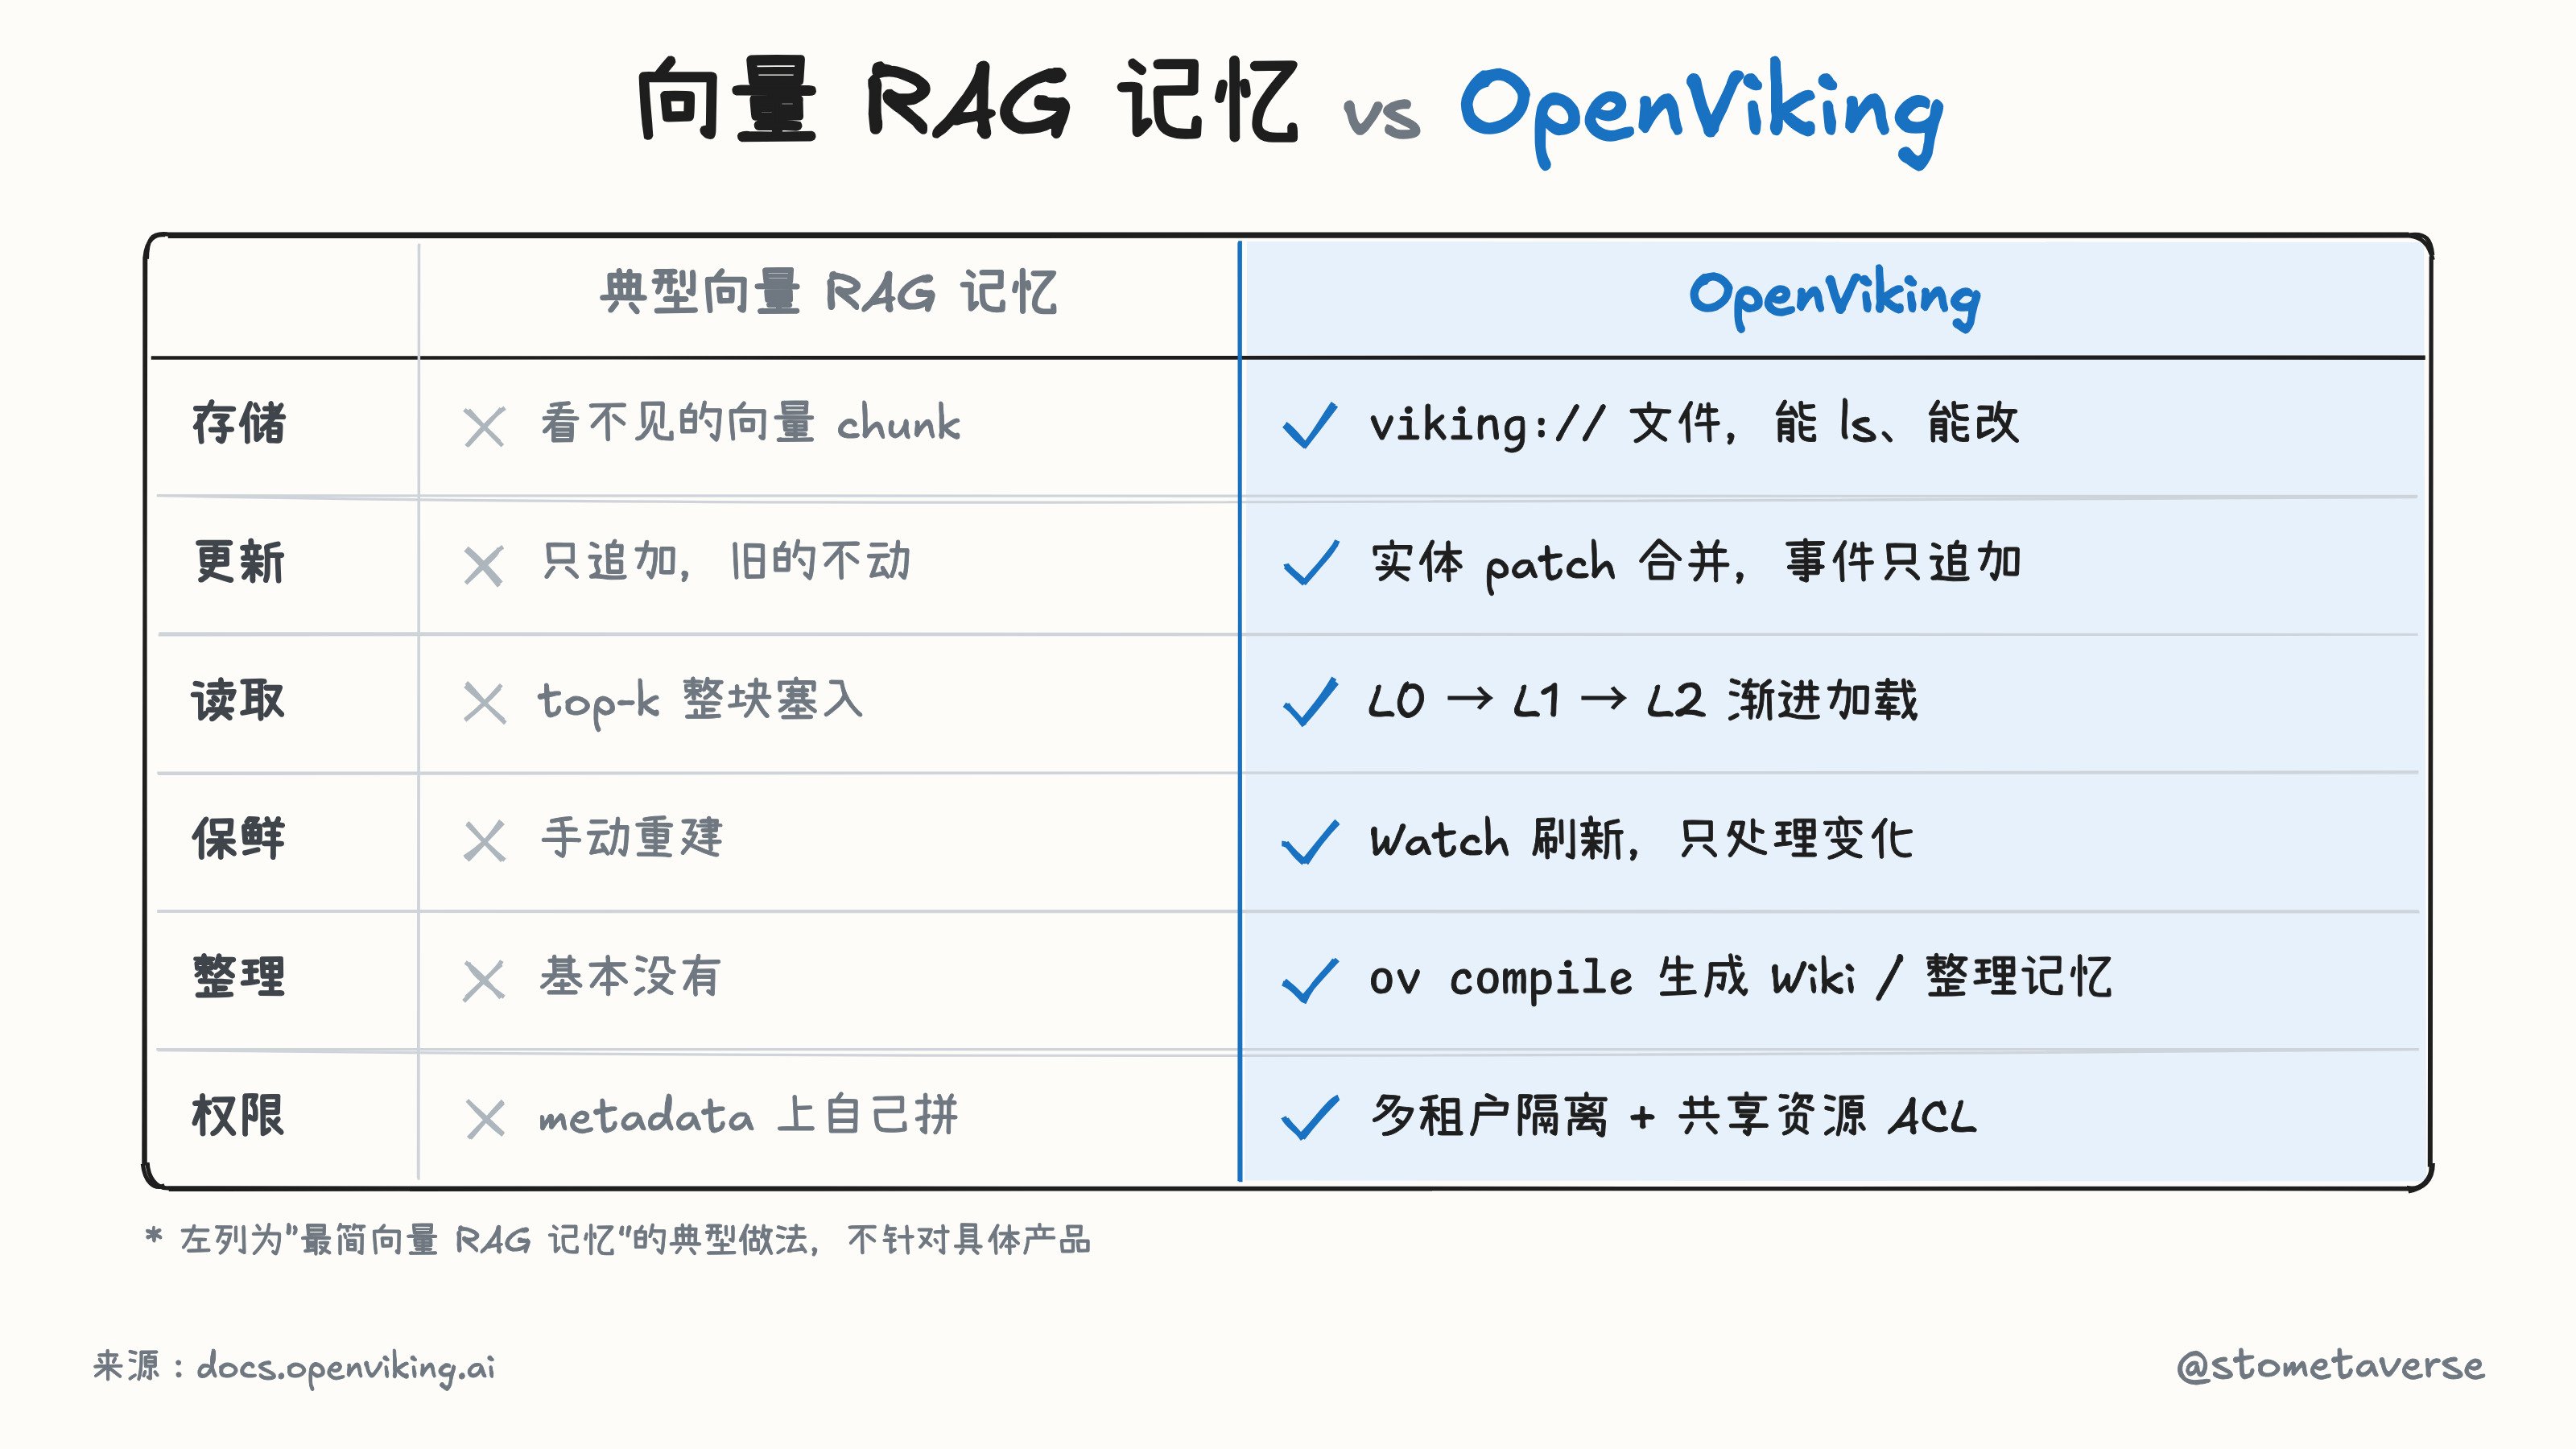
文字版(典型向量 RAG 记忆 → OpenViking):
- 存储:向量池里的 chunk,看不见 → viking:// 文件,能 ls、读、改
- 结构:同质的文本片段 → 类型化:实体、事件、偏好、经验……
- 更新:追加新 chunk,旧的不动 → 实体 patch 合并,事件只追加,memory_diff 可审计
- 读取:top-k 整块塞入 → L0 → L1 → L2 渐进加载
- 范围:一个扁平的索引 → 可按目录 / URI 限定检索范围
- 保鲜:手动重建 → Watch 定时刷新,只处理变化部分
- 整理:基本没有 → ov compile 生成 Wiki / 图谱,或整理记忆
- 权限:自己在 metadata 上拼 → account / user 隔离 + 共享资源 ACL
说明:左边是「最简向量 RAG 记忆」的典型做法,不针对任何具体产品。
🕳️ 我自部署踩过的坑
先交代难度:我的部署不是 docker compose up 一把梭。40 核服务器、本地模型推理(Ollama 跑 embedding)、一整套发布门禁。Claude Code 和 Codex 每收到一条 prompt,都会先去 OpenViking 召回记忆。
最大的坑,和 OpenViking 的设计无关,出在我自己的推理部署上:
- 7 天 560 条慢调用告警,交互查询平均排队 25 分钟,最长 70 分钟;而查询本身的处理只要 0.7 秒
- 原因:会话记忆提取要做大批量 embedding(单次最长 168 秒),和交互查询挤在同一个 8 核、单并发槽位的 Ollama 进程里
- 加核没用:加到 30 核,长任务一来,短查询 p95 还是 50 秒
- 真正的修法:拆成两个推理进程、两条队。快道 20 核给交互查询,慢道 10 核给批量任务
- 结果:热查询 p50 0.349 秒、p95 0.369 秒;批量任务全速跑的同时,短查询 p50 0.97 秒
一句话教训:核数决定任务跑多快,队列结构决定你等多久。
如果你也要带本地模型自部署,建议一开始就把交互查询和后台批量 embedding 分开。
另外 7 个和架构无关的坑(内核参数上限、bash 参数展开、Go 模板转义、不存在的日志行、mock 保真度、macOS tar 污染……),都写在博客里:
👉 www.stometa.dev/posts/openviking-self-hosting-cracks
🎯 适合谁
适合:
- 同时用多个 coding agent(Claude Code、Codex、Cursor……),希望它们共享一份跨会话记忆
- 想看清、也改得动 Agent 到底记住了什么
- 要把文档、代码仓库、飞书、网页统一喂给 Agent 的团队
- 需要多租户隔离和目录级权限的企业场景
上手前先想清楚:
- 自部署需要 Python 3.10+、一个 embedding 模型和一个 VLM;带本地推理会复杂很多
- 许可证是 AGPLv3,商用和二次分发前请自己评估
- 不想运维,可以用火山引擎托管版(官方写的是前 50 个文件免费)
- 如果只想给单个 Agent 加一点偏好记忆,可能用不着这么重的方案
🔗 链接
- GitHub:github.com/volcengine/OpenViking
- 在线试玩 Studio(免安装):openviking.ai/studio
- 文档:docs.openviking.ai
- 架构:docs.openviking.ai/concepts
- 上下文类型(Entity / Event 等):docs.openviking.ai/concepts
- L0 / L1 / L2:docs.openviking.ai/concepts
- Compile:docs.openviking.ai/context-compilation
- ACL:docs.openviking.ai/concepts
- 设计理念(官方博客):blog.openviking.ai/post/openviking-context-database
- 我的自部署实录:www.stometa.dev/posts/openviking-self-hosting-cracks
你现在给 Agent 用的是什么记忆方案?踩过什么坑?评论区聊。
觉得有用先收藏。后面我会继续写自部署和 Agent 记忆调优的实测。
首发于 X(2026-10-08):原文